Códigos de respuesta SIP 5xx: qué significan y cómo los gestiona un SBC
Cuando una llamada SIP falla, el código de respuesta indica quién falló y qué hacer al respecto, y la clase 5xx es la que decide si una llamada obtiene una segunda oportunidad. Un 5xx significa que la solicitud era perfectamente válida pero el servidor no pudo cumplirla, por lo que esa misma llamada a menudo tendrá éxito contra un servidor diferente. Esa propiedad es la razón por la que los códigos 5xx impulsan casi todo el comportamiento de conmutación por error (failover) y avance de ruta en una red de voz en producción. Si la gestión es correcta, un problema con un operador se convierte en un redireccionamiento invisible; si es incorrecta, se convierte en una llamada caída y un ticket de soporte.
La clase 5xx es la familia de “error del servidor” en SIP, definida en RFC 3261 junto con las otras cinco clases. En este artículo recorreremos cada código 5xx en términos de producción, qué buscar en una captura de paquetes y cómo un controlador de borde de sesión (SBC) convierte un error del servidor en un failover limpio en lugar de una llamada fallida. Si desea el diccionario completo que cubre desde 1xx hasta 6xx, la Guía completa de códigos de respuesta SIP es la referencia para tener abierta junto a esta página. Esta página profundiza exclusivamente en los 5xx.
Qué significa 5xx y en qué se diferencia de 4xx
Toda la clase 5xx se reduce a una decisión de enrutamiento: intentar en otro lugar. Un 5xx dice que la solicitud era sintácticamente válida pero el servidor que respondió no pudo completarla, lo que implica fuertemente que un servidor diferente podría hacerlo. Eso es lo opuesto a la mayoría de los códigos 4xx, donde la solicitud en sí era incorrecta y reintentarla sin cambios contra otro servidor a menudo fallará de la misma manera. Un 4xx generalmente significa detenerse; un 5xx generalmente significa avanzar a la siguiente ruta.
La otra propiedad útil es que un 5xx generalmente se genera salto a salto, por un intermediario a lo largo de la ruta (un proxy, un B2BUA o un conmutador de operador) en lugar del terminal llamado. Eso indica que la llamada nunca llegó al extremo remoto y proporciona un punto de partida para determinar qué elemento investigar. Para la taxonomía completa de las seis clases de respuesta y cómo interactúan, consulte la guía completa; el resto de esta página se mantiene dentro de la familia 5xx.
Los códigos 5xx, uno por uno
Para cada código a continuación: qué elemento lo emite normalmente, cómo se ve en una captura, qué efecto tiene en la llamada ascendente y lo primero que se debe verificar.
500 Server Internal Error
500 Server Internal Error es el código genérico de “algo falló de mi lado”. El servidor que respondió aceptó la solicitud y luego encontró un fallo que no puede describir con mayor precisión, a menudo un error de software, una búsqueda interna fallida o un recurso agotado en un conmutador de operador o servidor de aplicaciones. En una captura, llega como una respuesta final a su INVITE sin un cuerpo útil, a veces con un encabezado Warning que contiene una pista de una línea. Un solo 500 suele ser transitorio; 500 persistentes de un operador apuntan a un fallo de software en el equipo de ese operador, no a su configuración. Primera verificación: ¿es un par o todos? Un solo par significa abrir un ticket con ese operador y dejar que el SBC haga failover mientras tanto.
501 Not Implemented
501 Not Implemented significa que el servidor reconoció el método SIP pero no es compatible con él. El disparador clásico es un REFER enviado a un operador que no ofrece transferencia de llamadas, o un INFO o UPDATE que el lado remoto nunca implementó. La respuesta debería incluir un encabezado Allow que liste los métodos que el servidor admite, que es la forma más rápida de confirmar lo que aceptará. Primera verificación: lea el encabezado Allow y luego deje de enviar el método no admitido o gestione la función localmente en el SBC en lugar de retransmitirla.
502 Bad Gateway
502 Bad Gateway dice que el servidor que respondió recibió una respuesta inválida de un servidor más adelante en la cadena. En una cadena de SBC y proxies, un 502 del siguiente salto a menudo significa que el problema se originó más adelante en la cadena descendente. Es un indicador, no un destino. Primera verificación: capture en el lado remoto del siguiente salto si es posible, porque la falla real está más allá de quien le envió el 502.
503 Service Unavailable
503 Service Unavailable es el código de trabajo de toda la clase, y tiene su propia sección más adelante porque conlleva la mayor cantidad de matices. En resumen, significa que el servidor está lo suficientemente sano para responder pero no puede aceptar la solicitud en este momento, porque está sobrecargado, con límite de tasa, alcanzando un tope de sesiones o en mantenimiento. Es la señal sobre la que un SBC más quiere actuar, porque un 503 de una troncal es casi siempre una razón clara para hacer failover a otra. Primera verificación: confirme que su comportamiento de avance de ruta realmente hace failover en 503 y busque un encabezado Retry-After.
504 Server Time-out
504 Server Time-out es el primo de sistemas encadenados del 408 Request Timeout. La diferencia es de quién se agotó el temporizador. Un 408 significa que su propio temporizador de transacción expiró esperando cualquier respuesta. Un 504 significa que el servidor que le respondió estaba a su vez esperando a otro servidor ascendente que nunca respondió a tiempo. Entonces, 504 le dice que el servidor que respondió está activo y comunicándose, pero algo de lo que depende no lo está. Primera verificación: el servidor que devuelve el 504 es alcanzable, así que la falla está más allá de él; persiga la dependencia que agotó su tiempo en lugar del par que reportó el 504.
505 Version Not Supported
505 Version Not Supported significa que la versión de SIP en la línea de solicitud no es compatible. En la práctica, es una pieza de museo, porque SIP/2.0 ha sido la única versión implementada durante dos décadas. Si alguna vez ve uno, sospeche de una línea de solicitud malformada o una herramienta de prueba enviando datos inválidos, no de una negociación de versión real.
513 Message Too Large
513 Message Too Large significa que la solicitud excedió el tamaño que el servidor acepta en el transporte actual. Este código aparece en el mundo real más de lo que su oscuridad sugiere, casi siempre en UDP, cuando un INVITE crece más allá del límite del datagrama debido a un cuerpo SDP grande, un conjunto extenso de encabezados o un encabezado Identity voluminoso con un PASSporT de STIR/SHAKEN. La solución rara vez es reducir el mensaje; es mover ese par a TCP o TLS, donde los mensajes grandes no tienen la misma restricción. Primera verificación: ¿este par usa UDP con INVITE grandes? Cambie el transporte.
580 Precondition Failure
580 Precondition Failure proviene de RFC 3312 y significa que las precondiciones SDP en la oferta no pudieron cumplirse, normalmente una reserva de recursos de calidad de servicio que la red no pudo garantizar antes de conectar la llamada. Es poco común, y solo lo encontrará en interconexiones que condicionan el establecimiento de la llamada a la reserva de recursos. Primera verificación: si las precondiciones son realmente necesarias en este tramo, porque muchas implementaciones las negocian cuando no las necesitan.
503, Retry-After y control de sobrecarga
503 merece su propio tratamiento porque es el único código 5xx con un comportamiento de gestión integrado en su diseño. Es la forma estándar para que un servidor diga “estoy bien, pero estoy lleno o en mantenimiento, así que vuelva más tarde o vaya a otro lugar”. Tratar cada 503 como un fallo definitivo descarta todo el propósito del código.
La pieza clave es el encabezado Retry-After, definido en RFC 3261 sección 20.33. Cuando un servidor incluye Retry-After, le indica al llamante cuántos segundos esperar antes de reintentar contra ese servidor específico. Un SBC bien configurado lo respeta despriorizando temporalmente esa ruta durante el intervalo indicado, en lugar de golpear a un servidor que explícitamente pidió un respiro. Ignorar Retry-After y reintentar inmediatamente tiende a empujar a un servidor ya cargado aún más allá del límite.
Más allá del Retry-After por mensaje, SIP define una forma estandarizada para que un servidor ocupado solicite al ascendente que reduzca el tráfico antes de tener que empezar a rechazar todo. RFC 5390 establece los requisitos para el control de sobrecarga SIP, y RFC 7339 define el mecanismo: parámetros de control de sobrecarga transportados en el encabezado Via que permiten a un elemento descendente indicar a su vecino ascendente que reduzca un porcentaje del tráfico. Cuando ambos lados lo implementan, la congestión se gestiona de forma gradual y las tormentas de 503 nunca comienzan. Sin embargo, muchos pares no lo implementan y simplemente emiten 503 una vez que alcanzan su límite, por lo que la reacción de su SBC ante un 503 simple sigue siendo importante.
Las conclusiones prácticas son simples. Un 503 de un primario sano debería hacer failover limpiamente a una ruta de respaldo. Una oleada repentina de 503 es una señal de capacidad o interrupción a nivel de troncal, no un defecto por llamada, y debería leerse como “este operador tiene problemas” en lugar de “esta llamada fue mala”.
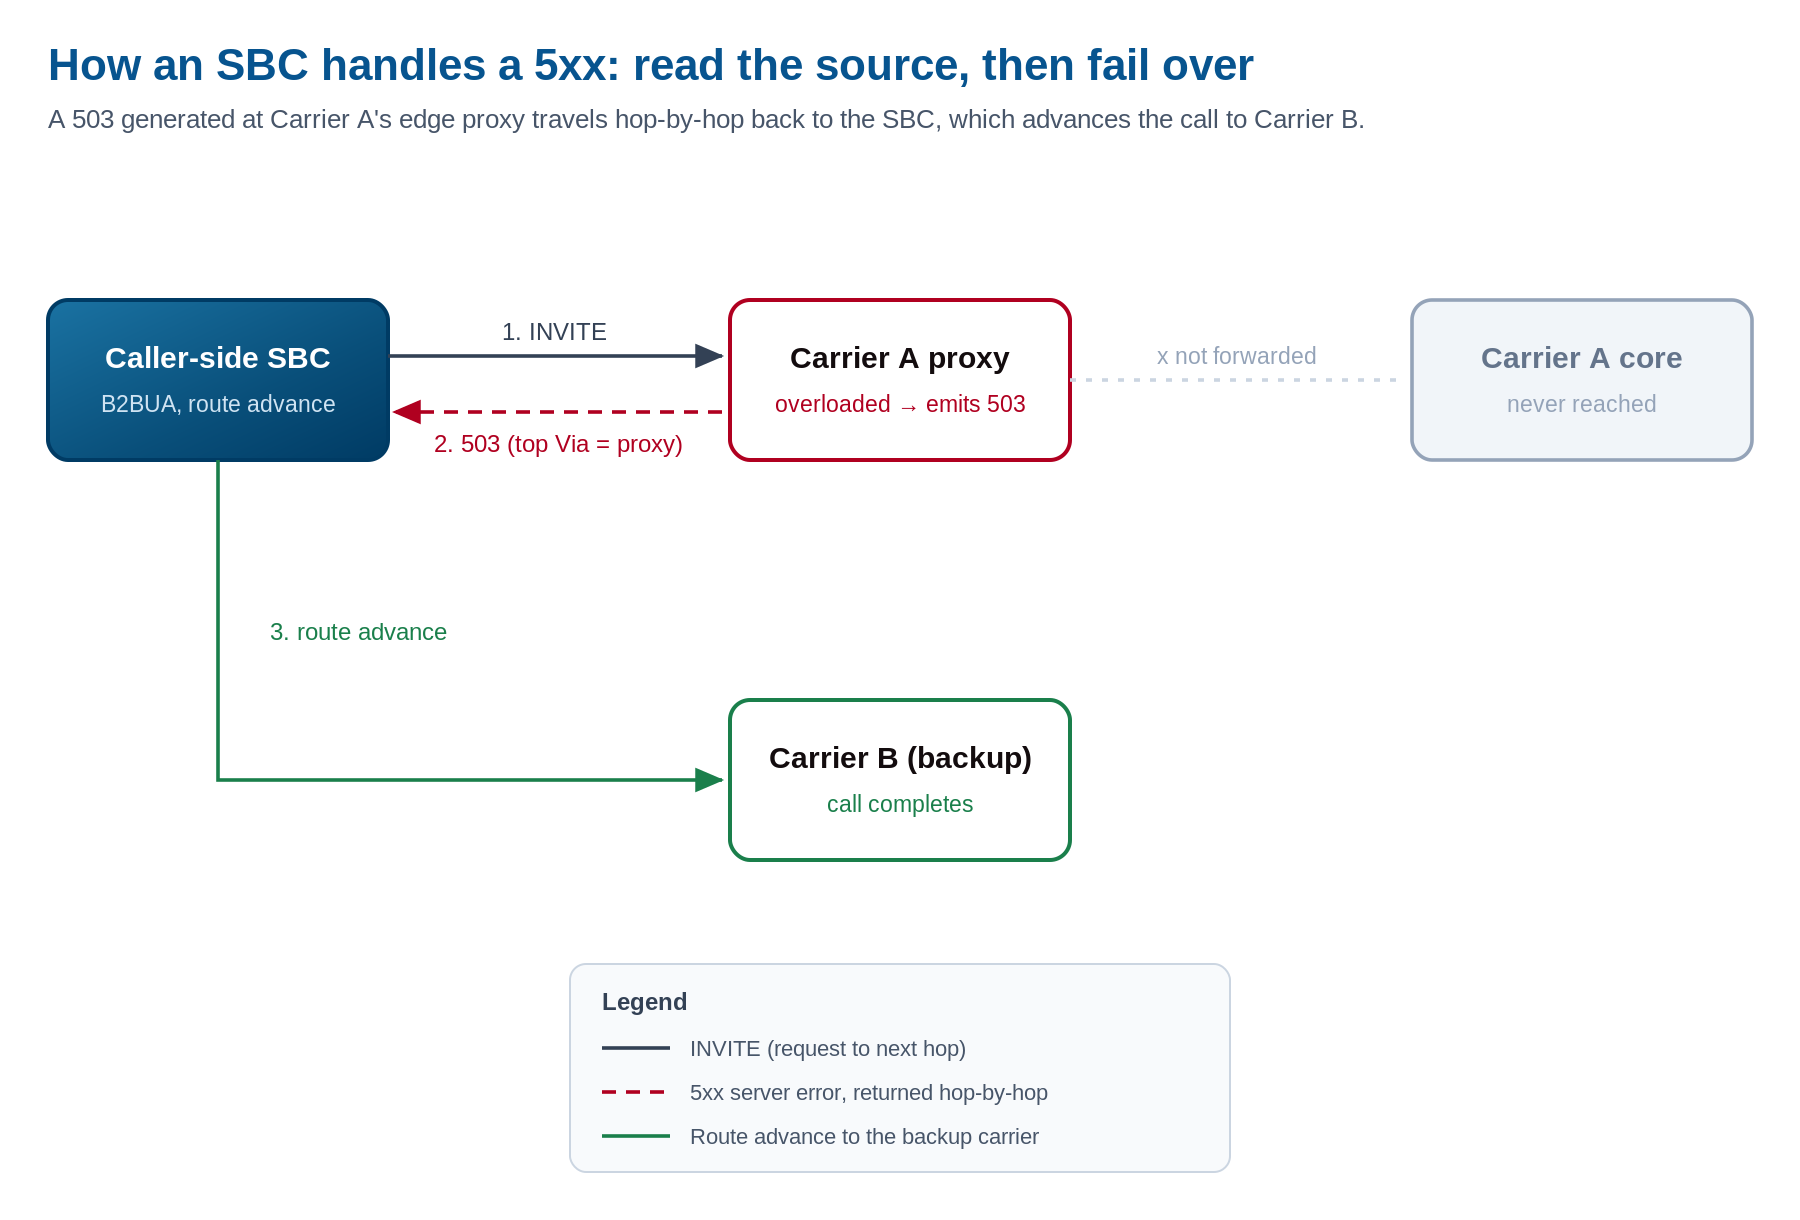
Un 503 se genera en el proxy de borde del Operador A y viaja salto a salto de regreso al SBC, no desde el núcleo del operador detrás de él. El SBC lee el Via superior para ver qué elemento falló y luego avanza la llamada a un operador de respaldo. Haga clic para ampliar.
Cómo se ve un 5xx en una captura de paquetes
Leer un 5xx en una traza consiste principalmente en responder una pregunta: ¿qué elemento lo envió? La pila del encabezado Via es donde se encuentra la respuesta. La entrada Via superior asociada con el procesamiento de la respuesta identifica el salto que la generó, por lo que un 503 cuyo Via superior es el proxy de borde del operador fue emitido allí, no por el conmutador de destino detrás de él. Eso le indica inmediatamente hasta dónde llegó la llamada.
La naturaleza salto a salto de la mayoría de los códigos 5xx es en sí misma una pista. Dado que un intermediario generó la respuesta, no llevará el contexto de extremo a extremo que se vería del lado llamado, lo cual confirma que la llamada nunca llegó al extremo remoto. Busque también un encabezado Warning, definido en RFC 3261, que a menudo contiene una explicación corta legible por humanos, y un encabezado Reason de RFC 3326, que puede transportar un valor de causa Q.850 cuando la falla se está puenteando desde una red TDM. Esos dos encabezados son donde normalmente se oculta el “por qué”.
Un comportamiento más que vale la pena conocer para la lectura de trazas: el ACK para respuestas finales no-2xx se genera dentro de la transacción INVITE y sigue la ruta de señalización existente, a diferencia del ACK de extremo a extremo que requiere un 200 OK. Si ve un 5xx sin un ACK correspondiente, la transacción no se cerró correctamente, y eso es un problema aparte a investigar. Para el método general de lectura de cualquier traza SIP, una guía dedicada de trazas cubre los puntos de captura y las herramientas, y el artículo de flujo de llamada SIP muestra dónde aparecen estos códigos en una llamada completa; esta sección es solo la parte específica de 5xx.
Cómo gestiona un SBC los códigos 5xx
La razón por la que un SBC se ubica en el borde de una red multioperador es precisamente para que el error de un solo servidor no se convierta en la llamada caída de su cliente. Un SBC con arquitectura B2BUA termina el tramo entrante y origina un tramo saliente independiente, lo que significa que ve el 5xx en un lado y decide, en sus propios términos, qué debería escuchar el otro lado. El mismo control que impulsa la manipulación de encabezados SIP y la señalización SIP en cada tramo le permite reescribir un código de respuesta o cambiar qué decisión de enrutamiento activa.
El comportamiento central es el avance de ruta. El SBC mapea un 5xx a “avanzar a la siguiente ruta” para que un error del servidor en un operador haga failover de la llamada a una ruta de respaldo, mientras que un 4xx generalmente se deja para detener la llamada, porque reintentar una solicitud rechazada en otro lugar rara vez ayuda. Respetar Retry-After es la siguiente capa: cuando un 503 lo incluye, el SBC marca esa ruta como inactiva durante el intervalo indicado en lugar de reintentar contra un muro. Los 503 repetidos del mismo par pueden sacarlo de la rotación completamente hasta que los keepalives OPTIONS muestren que se ha recuperado, de modo que un operador degradado deja de atraer tráfico automáticamente.
Las redes reales son lo suficientemente complejas como para que estas decisiones necesiten configurarse por grupo de troncales en lugar de globalmente, porque el 503 de un operador podría significar congestión genuina mientras que el de otro señala una interrupción que se quiere escalar de inmediato. ProSBC gestiona esto con control por tramo en hasta 1,024 puntos de acceso a la red (grupos de troncales), de modo que el comportamiento de avance de ruta y código de causa para cada par puede coincidir con lo que ese par realmente hace. Con más de veinte años de implementación de SIP en operadores y capacidad para hasta 60,000 sesiones por servidor, ese control por par es lo que mantiene la gestión de 5xx coherente cuando docenas de operadores se comportan de manera diferente a gran escala.
La última pieza es la visibilidad. Una tasa creciente de 5xx en una troncal es la señal más temprana legible por máquina de una interrupción del lado del operador, generalmente visible para su monitoreo antes de que un solo cliente lo note. Presentar los conteos de 5xx por ruta en un panel, con umbrales de alerta, convierte los mismos códigos que impulsan el failover automático en un sistema de alerta temprana para los humanos de guardia.
Preguntas frecuentes
¿Un 503 es una falla de llamada?
No realmente. Un 503 es una señal de “reintentar en otro lugar”, y si su SBC hace failover correctamente, la llamada aún se completa. Filtre los eventos de 503-luego-failover de sus métricas brutas de falla y repórtelos como failovers exitosos, o sus paneles exagerarán cuántas llamadas realmente fallaron.
¿Debería reintentar un 5xx contra el mismo servidor?
Solo después del intervalo en un encabezado Retry-After, o con un retroceso razonable. Un reintento inmediato contra el mismo servidor generalmente produce el mismo 5xx, y durante una sobrecarga lo empeora.
¿Cuál es la diferencia entre 408 y 504?
De quién se agotó el temporizador. Un 408 Request Timeout significa que su propia transacción se agotó esperando cualquier respuesta. Un 504 Server Time-out significa que el servidor le respondió pero estaba esperando a otro servidor ascendente que nunca respondió. Con un 504, el par con el que habla está activo; la dependencia detrás de él no lo está.
¿Por qué recibo un 503 de un operador que claramente está activo?
Casi siempre es capacidad, no salud. Los topes de sesión, los límites de tasa y el control de sobrecarga se manifiestan como 503 desde un conmutador perfectamente sano. Significa “lleno”, no “averiado”.
¿Por qué los INVITE grandes regresan con un 513?
El mensaje excedió el límite de tamaño del transporte, que en la gran mayoría de los casos es una restricción de datagrama UDP. Mueva ese par a TCP o TLS y el INVITE sobredimensionado, a menudo inflado por un SDP grande o un encabezado Identity de STIR/SHAKEN, pasará sin problema.
Conclusión
La clase 5xx es pequeña pero de alto valor: errores del lado del servidor que generalmente son reintentables en otro lugar, y el motor detrás de casi cada failover limpio en una red de voz. Saber qué elemento emitió el código, si un Retry-After está adjunto y si la causa es salud o capacidad es lo que convierte un error del servidor en una llamada redirigida en lugar de una llamada perdida. Tenga la guía completa de códigos de respuesta a mano para las otras cinco clases, y trate los 5xx como su kit de herramientas de avance de ruta.
Convierta cada error del servidor en un failover limpio con ProSBC
Como B2BUA completo, ProSBC termina y re-origina cada tramo de llamada, de modo que puede convertir cualquier 5xx de un par en la decisión de enrutamiento que su red realmente necesita: avanzar a un operador de respaldo, respetar un intervalo Retry-After, mantener un par sobrecargado fuera de rotación hasta que se recupere y alimentar la tasa de 5xx directamente al monitoreo.
Su motor de enrutamiento basado en reglas y controlado por API permite failover multiruta basado en prioridad, y el control por NAP en hasta 1,024 grupos de troncales significa que el uso idiosincrático de 503, 500 y el resto por parte de cada operador puede gestionarse en sus propios términos en lugar de con una única regla global general.
Descargue gratis el Runbook de resolución de problemas de voz
Un PDF de 22 páginas revisado por el soporte técnico de TelcoBridges, con las primeras verificaciones para los 9 síntomas de voz más comunes, 14 códigos de respuesta SIP explicados y 3 formas de capturar una traza de llamada.
Al enviar este formulario, su información será procesada de acuerdo con nuestra Política de privacidad.
¿Prefiere evaluar por su cuenta primero? Cree su laboratorio gratuito.