Guía de resolución de problemas VoIP: problemas comunes, diagnóstico de primera línea y dónde buscar después
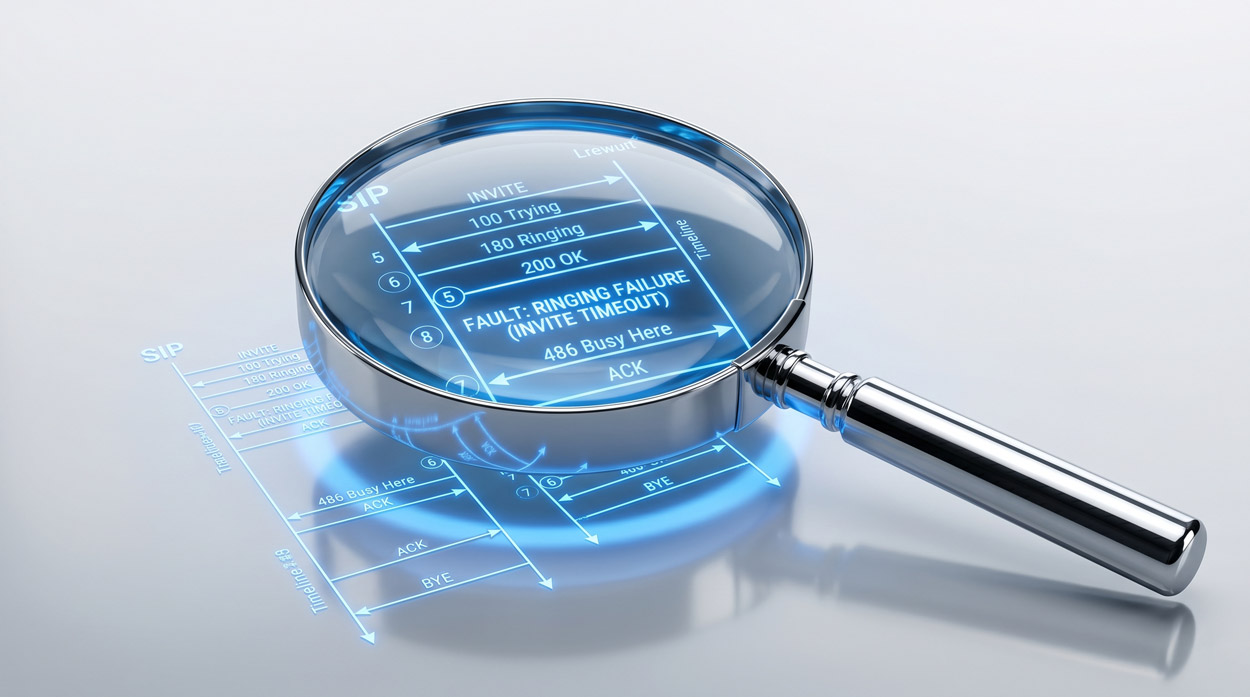
Cuando un cliente reporta que su VoIP no funciona, los primeros diez minutos definen el tono del resto del ticket. La acción correcta rara vez es empezar a cambiar configuraciones. Es capturar suficiente evidencia para aislar dónde reside la falla y luego aplicar la corrección más pequeña posible. Esta guía es la visión ejecutiva de la resolución de problemas VoIP: los síntomas que los operadores ven con mayor frecuencia, el paso diagnóstico que aísla cada uno rápidamente y las guías complementarias a seguir cuando un síntoma requiere un análisis profundo.
La estructura es deliberadamente orientada a síntomas. El artículo mapea cada síntoma a sus causas más probables, la única pieza de evidencia que las confirma o descarta, y las rutas de solución que resuelven la llamada.
El diagnóstico de 5 minutos
Antes de cambiar una sola configuración, capture la evidencia. Reconfigurar antes de comprender a fondo la causa raíz puede generar más tiempo de inactividad.
Las cinco piezas de información que debe recopilar primero son: cuándo se realizó la llamada (marca de tiempo al segundo), la dirección (entrante o saliente desde la perspectiva del operador), los números de origen y destino, si se requirió transcodificación y el error exacto que el usuario vio o escuchó. Si el usuario “simplemente no escuchó nada,” ese es un problema diferente de “obtuvo un tono de ocupado rápido,” que a su vez es diferente de “la llamada se conectó y luego se cortó después de veinte segundos.”
El siguiente paso es aislar la falla a lo largo de cuatro ejes. ¿Fue una falla de señalización (la llamada nunca se conectó) o una falla de medio (la llamada se conectó pero el audio falló)? ¿La falla ocurrió en el lado de origen del SBC o en el lado de destino? ¿Fue una llamada on-net (entre dos endpoints que el operador controla) u off-net (hacia un destino externo)? ¿Y fue un evento aislado, un patrón intermitente o una falla sistemática que afecta a todas las llamadas?
La pregunta más diagnóstica en esta etapa es casi siempre: ¿esto funcionaba antes? Si la respuesta es sí, la siguiente pregunta es qué cambió. Una rotación de certificado, una actualización de regla de enrutamiento, un cambio de operador aguas arriba, una aplicación de política de firewall o una actualización de software es la causa de una proporción desproporcionada de incidentes VoIP. El registro de cambios generalmente encuentra el problema más rápido que el rastreo.
Síntoma 1: las llamadas no se conectan
La llamada falla antes de que el audio tenga siquiera una oportunidad. Sin timbre, sin respuesta, sin medio.
Las causas más probables son una falla de señalización SIP (el INVITE nunca recibe un 200 OK), un registro que no se ha realizado o ha expirado (el endpoint no puede ser alcanzado porque no está registrado), una ACL o regla antifraude que bloquea la IP de origen o el número llamado, una regla de enrutamiento que no coincide con el patrón marcado, o una falla de handshake TLS en una troncal cifrada.
El primer paso diagnóstico es leer el código de respuesta SIP en el INVITE que falla. Una respuesta 4xx significa que la solicitud tuvo un problema del lado del cliente (autenticación, permiso, formato, códec). Una respuesta 5xx significa que el servidor no pudo procesar la solicitud aunque la solicitud en sí era válida (tiempo de espera, error interno, sin recursos). Una respuesta 6xx es un rechazo global que debe tratarse como final. Para el catálogo completo, consulte la referencia complementaria sobre fundamentos de señalización SIP; los patrones que más se repiten en operaciones reales se presentan a continuación.
Un 403 Forbidden casi siempre significa control de acceso. O las credenciales fallaron la autenticación, o una regla antifraude ha puesto el destino en lista negra. Un 404 Not Found generalmente significa que el número marcado no coincidió con ninguna regla de enrutamiento. Un 408 Request Timeout significa que el siguiente salto no respondió, frecuentemente porque el par es inalcanzable en la red o ha dejado de enviar OPTIONS. Un 488 Not Acceptable Here típicamente apunta a una discrepancia de códec: el SDP entrante no ofreció ningún códec que el lado de destino acepte. Un 503 Service Unavailable significa, específicamente, que el siguiente salto no está aceptando llamadas en este momento. Eso frecuentemente significa que el siguiente salto está sobrecargado, aunque no es necesariamente el caso y puede ser una suposición peligrosa al investigar problemas.
Síntoma 2: problemas de conexión de audio, sin audio y audio unidireccional
La llamada se señalizó exitosamente (se recibió el 200 OK, se envió el ACK), pero el audio falta en una o ambas direcciones. Los usuarios típicamente lo describen como “yo los escucho pero ellos no me escuchan” o “la llamada se conecta con silencio total.”
Las cuatro causas raíz probables son un firewall bloqueando la ruta RTP, un SDP que anuncia la dirección IP o rango de puertos incorrecto, un problema de enrutamiento asimétrico donde el RTP va en una dirección por una ruta y en la otra dirección por una ruta diferente, o una discrepancia de clave SRTP donde un lado no puede descifrar el medio del otro.
El primer paso diagnóstico es capturar tanto la señalización como el medio en la interfaz del SBC. Si los paquetes RTP fluyen en una sola dirección, el problema es un firewall bloqueando en el lado que no fluye. Si el RTP no fluye en absoluto, el problema está en el SDP, generalmente una dirección IP privada anunciada donde se esperaba una pública, o un puerto de medio fuera del rango permitido del firewall. Si el RTP fluye en ambas direcciones pero el audio es silencioso o distorsionado, el problema es de cifrado o negociación de códec.
Síntoma 3: problemas de calidad de audio
La llamada se conecta, ambos lados escuchan audio, pero el audio es malo. Entrecortado, robótico, con cortes, eco, o simplemente por debajo del nivel de calidad de voz que el SLA del operador prometió.
Las causas probables son pérdida de paquetes (típicamente cualquier valor por encima del 1% se vuelve audible), jitter que excede el tamaño del buffer del receptor, latencia de extremo a extremo superior a 150 ms en una dirección, artefactos de transcodificación (especialmente cuando está involucrado un códec de baja tasa de bits), o eco proveniente de un tramo híbrido en algún punto de la ruta.
El primer paso diagnóstico es verificar la herramienta de rastreo de llamadas del SBC. Si el MOS está por debajo de 3.5, el códec es G.711 y la llamada tiene más de unos segundos de audio, la red es la sospechosa, no el SBC. El desglose del MOS en sus componentes (jitter, pérdida de paquetes, latencia) señala la capa específica que está fallando. Los umbrales completos, la metodología de monitoreo por troncal y la arquitectura de métricas se cubren en el artículo complementario sobre mejores prácticas de monitoreo VoIP, que debería ser la referencia operativa para cualquier persona que esté construyendo una práctica de monitoreo de calidad.
En operaciones reales, tres patrones producen la mayoría de las quejas de calidad. Congestión WAN en una ruta de operador específica, generalmente visible como pérdida de paquetes aumentando en llamadas enrutadas a través de esa troncal mientras otras troncales permanecen limpias. QoS que se suponía debía aplicarse pero no se aplicó. Y buffers de jitter dimensionados para un perfil de red diferente al que está en uso, ya sea demasiado pequeños (de modo que el jitter se convierte en cortes audibles) o demasiado grandes (de modo que la latencia se vuelve audible).
Síntoma 4: las llamadas se cortan a mitad de conversación
La llamada se conectó, el audio fluía, y luego la llamada finalizó sin que ninguna de las partes colgara. La descripción del usuario suele ser “nos cortaron.”
Las causas probables son la expiración del temporizador de sesión sin una renovación, una falla de keepalive RTP que causa que un lado agote el tiempo de espera del medio, un binding NAT que expiró y eliminó la ruta, un BYE iniciado por el par provocado por detección de silencio (algunos PBX cortan llamadas que creen que han terminado), o una interrupción de red en una troncal cifrada con TLS que rompió el canal seguro.
La pregunta más diagnóstica es exactamente cuándo finalizó la llamada. Si las llamadas se cortan consistentemente casi exactamente a la misma duración, la causa es un temporizador en algún punto de la ruta. Treinta y dos segundos generalmente apunta a un Session Refresh que no se está respetando. Si el tiempo de corte es aleatorio, la causa es de red: un enlace inestable, una recarga transitoria de firewall o un evento de convergencia BGP aguas arriba.
Los problemas de temporizador de sesión son el subconjunto más común de cortes a mitad de llamada y los más fáciles de corregir desde el SBC. La regla de normalización consiste en insertar un encabezado Session-Expires con un valor que el destino acepte, o eliminar el temporizador completamente en los tramos que lo manejan mal.
Síntoma 5: bucles de registro o endpoints fuera de línea
El endpoint aparece como fuera de línea en el panel de administración.
Las causas probables son una ACL que bloquea el tráfico REGISTER (frecuentemente porque una regla antifraude confundió un re-registro legítimo con un ataque de escaneo), discrepancia de credenciales después de una rotación de contraseña, un intervalo de keepalive NAT mayor que el tiempo de espera del binding, tráfico de escáner o ataque confundiendo la lógica de detección, o un certificado TLS que ha expirado en cualquiera de los dos lados.
El primer paso diagnóstico es extraer los logs del SBC del endpoint afectado. El log mostrará los intentos de registro y cómo respondió el SBC. Un desafío 401 seguido de un 200 OK exitoso es el patrón saludable. Un 401 seguido de otro 401 indica que el SBC rechazó el registro directamente. Identificar la causa raíz debe hacerse a nivel del registrar. Si el SBC es el registrar, esos logs serán informativos. Si el SBC no es el registrar, los logs del SBC solo le dirán hasta cierto punto.
La guía complementaria sobre prevención de ataques SIP DoS cubre en profundidad el límite entre patrones de registro legítimos y ataques de escaneo, y es la referencia a utilizar al ajustar umbrales.
Síntoma 6: fallas de DTMF
La llamada se conecta con buen audio, pero el IVR no puede leer los dígitos que el usuario está presionando.
Las causas probables son una discrepancia de modo DTMF (un lado envía tonos de audio in-band, el otro espera telephone-events RFC 2833 o mensajes SIP INFO), transcodificación eliminando el DTMF en su paso, o una discrepancia de tipo de payload en el payload RTP de telephone-event (un lado usando payload type 101, el otro esperando 96).
El primer paso diagnóstico es capturar el medio y verificar que lo que se está enviando coincide con lo que debería enviarse. Si el usuario presiona un dígito y el rastreo muestra un paquete telephone-event RFC 2833 con el número correcto, el problema está aguas abajo. Si el rastreo muestra tonos de audio in-band pero el destino negoció RFC 2833, esa es la discrepancia. Un SBC B2BUA con una unidad de transcodificación puede normalizar entre modos DTMF por tramo, lo cual es generalmente la solución más rápida para entornos mixtos.
Un caso específico que vale la pena señalar: los códecs de baja tasa de bits (cualquiera que comprima agresivamente) pueden eliminar el DTMF in-band por completo. Si la ruta incluye una transcodificación y el origen está enviando tonos in-band, la llamada no puede transportar DTMF de manera confiable. La solución es negociar telephone-events RFC 2833 de extremo a extremo, o mantener la ruta en G.711 si el DTMF debe permanecer in-band.
Síntoma 7: fallas de fax
El fax es extremadamente sensible a la pérdida de paquetes, el jitter y la elección de códec. Las causas probables son transcodificación agresiva rompiendo el protocolo T.30, pérdida de paquetes por encima del umbral de tolerancia del fax (generalmente alrededor del 0.5%), ausencia de negociación T.38 cuando ambos lados lo soportan, o un buffer de jitter absorbiendo los tonos de handshake V.21 al inicio de la sesión de fax.
El primer paso diagnóstico es identificar si la ruta es T.38 relay o G.711 passthrough. T.38 demodula la señal de fax en un protocolo digital sobre UDPTL, que tolera bien la pérdida y el jitter. G.711 passthrough transporta los tonos analógicos de fax dentro del códec de voz, lo cual es frágil ante cualquier pérdida. Si la ruta intentó negociar T.38 pero volvió a G.711, la renegociación de SDP generalmente muestra la razón. La guía complementaria sobre Fax over IP y T.38 cubre la ruta diagnóstica completa, el perfil de códec seguro para fax y las configuraciones del SBC que hacen que el fax funcione de manera confiable.
Síntoma 8: las llamadas no llegan al destino especificado
La mayoría de las llamadas tienen éxito, pero un número, prefijo u operador específico rechaza llamadas consistentemente.
Las causas probables son un rechazo del lado del operador (caller ID no incluido en lista blanca, nivel de atestación demasiado bajo, bloqueo geográfico), una discrepancia de formato de número (E.164 versus nacional versus local, o dígitos adicionales en el encabezado From), una regla de mapeo por NAP que falta para el nuevo destino, o un problema de atestación STIR/SHAKEN donde las llamadas firmadas por debajo del nivel A están siendo bloqueadas por el operador de terminación.
El diagnóstico más útil es identificar la troncal SIP o NAP por la que pasó la llamada fallida, luego re-enrutar a través de una alternativa. Si la llamada tiene éxito en la troncal alternativa, la normalización, atestación o lógica de enrutamiento de la troncal original es el problema. Si aún falla en la alternativa, el lado de destino está rechazando basándose en algo dentro de la llamada (caller ID, atestación, lista de bloqueo).
Si las fallas se agrupan alrededor de cambios regulatorios recientes, revise la atestación. Varios operadores grandes de EE. UU. degradan o bloquean llamadas firmadas por debajo del nivel A, y los proveedores que dependían de un socio mayorista aguas arriba para la firma han visto caer su atestación efectiva. La guía de atestación STIR/SHAKEN nivel A cubre la ruta operativa de nivel C a nivel A y los requisitos de la FCC para cada uno.
Síntoma 9: problemas específicos de Teams Direct Routing
Microsoft Teams Direct Routing tiene su propio conjunto de patrones de falla porque los requisitos de SBC de Microsoft son estrictos y no negociables. Fallas de heartbeat SIP OPTIONS, errores de handshake TLS, discrepancias de FQDN entre el certificado del SBC y lo registrado en Teams Admin Center, y problemas de negociación SRTP son los más comunes.
Una verificación de primera línea es el estado del SBC en Teams Admin Center. Si muestra fuera de línea, el heartbeat OPTIONS está fallando. La causa generalmente es un problema de handshake TLS (certificado expirado, certificado intermedio faltante, o el próximo cambio de lista de confianza de CA raíz de Microsoft), o una ruta de red que se ha caído entre el SBC y Microsoft. La actualización de certificado de CA raíz de Microsoft 2026 es el escenario de falla a corto plazo más importante a verificar. Para los requisitos completos de Direct Routing y los criterios de selección de SBC, consulte la página de aprendizaje de Teams Direct Routing.
El kit de herramientas de diagnóstico
Cuatro herramientas cubren la gran mayoría del trabajo de resolución de problemas VoIP, y un operador que tiene las cuatro listas antes de que llegue el primer ticket resuelve los problemas varias veces más rápido que uno que tiene que reunirlas bajo presión.
El rastreo de llamadas propio del SBC es la primera parada para cualquier pregunta de señalización, volcando un diagrama de escalera SIP por llamada que muestra cada mensaje intercambiado en ambos tramos. La salida de CDR del SBC proporciona el resumen posterior a la llamada, incluyendo duración, códecs, MOS y causa de colgado. Las traps SNMP y un tablero básico de monitoreo cubren los patrones sistemáticos. Y una captura PCAP en la interfaz del SBC, abierta en Wireshark, brinda la verdad sin procesar cuando los rastreos y CDR no coinciden sobre lo que sucedió.
Cuándo escalar al operador
Tres señales sugieren fuertemente que el problema está aguas arriba en lugar de en la propia infraestructura del operador. Múltiples troncales de origen ven la misma falla hacia el mismo rango de destino. Múltiples destinos en una sola troncal fallan al mismo tiempo. El rastreo SIP del SBC muestra la respuesta de falla originándose del lado del operador (5xx, 6xx, o un retardo prolongado seguido de 408).
El paquete a entregar al operador siempre debe incluir un rastreo SIP que cubra la llamada fallida desde la perspectiva del SBC, un PCAP de la interfaz del SBC para el período de tiempo relevante, y un pequeño conjunto de ejemplos concretos de llamadas (llamante, llamado, marca de tiempo exacta, duración, error). Los operadores se mueven mucho más rápido cuando la solicitud incluye la evidencia específica que necesitan para encontrar la llamada en sus propios logs. Los tickets vagos que dicen “las llamadas al código de área 305 están fallando” sin marcas de tiempo y ejemplos de números quedan en la cola.
Cómo ProSBC ayuda a resolver problemas VoIP más rápido
ProSBC está construido alrededor de la realidad operativa de que los problemas de voz ocurren y deben diagnosticarse rápidamente. La puntuación MOS por llamada se calcula de forma nativa en el SBC, sin necesidad de una sonda externa. La salida de CDR de ProSBC incluye la ruta de señalización, causa de colgado, códec en cada tramo y campos de calidad, tanto en formatos de texto como RADIUS. La captura de paquetes compatible con Wireshark en vivo puede habilitarse por llamada o por NAP sin reiniciar nada. El rastreo de llamadas SIP está disponible a través de la interfaz de administración web.
El motor de enrutamiento programable en Ruby es el punto de apalancamiento para patrones de problemas sistemáticos. Cuando un operador específico envía consistentemente encabezados malformados, artefactos de transcodificación o códigos de respuesta inusuales, un script de enrutamiento puede normalizar el patrón en la capa del SBC en lugar de requerir que cada PBX aguas abajo lo maneje. El mismo motor soporta integración de cadena de filtros con TransNexus ClearIP, Neustar, SecureLogix y YouMail para las decisiones de fraude, STIR/SHAKEN y puntuación de reputación que afectan la finalización de llamadas.
Para operadores que se encuentran ejecutando una práctica de diagnóstico en lugar de administrar su negocio, el Servicio Administrado de TelcoBridges se encarga del trabajo de diagnóstico, los cambios de configuración y el monitoreo continuo, liberando al operador de esa carga y manteniendo visibilidad y control total con el cliente.
Resuelva problemas VoIP más rápido con ProSBC
ProSBC es un controlador de borde de sesión (SBC) de grado carrier, basado en software, diseñado con la superficie de diagnóstico que las operaciones reales necesitan. MOS por llamada, captura de paquetes en vivo, salida completa de CDR, rastreo SIP basado en web y normalización programable a través del motor de enrutamiento Ruby cubren el flujo de trabajo de diagnóstico desde el primer síntoma hasta la causa raíz.
Para proveedores de servicio que ejecutan el monitoreo como práctica, MaaS (Monitoring as a Service) está disponible como producto independiente que lleva las métricas a un panel administrado. Para operadores que desean eliminar por completo la carga de diagnóstico, el nivel de Servicio Administrado incluye ProSBC+ con alta disponibilidad 1+1, soporte 24×7 Nivel 3, cambios de configuración continuos y monitoreo permanente.
ProSBC está disponible en AWS, Microsoft Azure, VMware, KVM/Proxmox y bare metal. Una prueba gratuita de 30 días con 500 sesiones concurrentes proporciona un entorno de diagnóstico completo para evaluación, y la licencia permanente ProSBC Lab de 3 sesiones está disponible de inmediato para trabajos de prueba y validación.
¿Prefiere evaluar por su cuenta primero? Inicie su prueba gratuita de 30 días.