SNMP para monitoreo de SBC y VoIP: puertos, MIB y práctica operativa
Cómo funciona realmente SNMP en infraestructura de voz: qué puertos transportan qué, cómo leer el MIB del SBC, cuándo hacer sondeo (polling) en lugar de escuchar trap, y cómo conectarlo todo a la plataforma de monitoreo que usted ya utiliza.
SNMP (Simple Network Management Protocol) es el lenguaje común que hablan las plataformas de gestión de red, y un controlador de borde de sesión ubicado en el borde de la red de voz es un dispositivo más que debería reportar en los mismos paneles que sus routers, switches y servidores. El protocolo es de propósito general, pero la forma en que se aplica a una plataforma de voz tiene sus particularidades: los contadores que importan son los de llamadas y registros, las alarmas que lo despiertan son las conmutaciones por error de alta disponibilidad y los ataques a nivel SIP, y las exigencias de seguridad son mayores porque el dispositivo se encuentra en el perímetro de la red.
Si usted es un ingeniero responsable de mantener saludable la infraestructura de voz, este artículo lo guía a través de SNMP desde el ángulo operativo: los puertos que utiliza y por qué, la diferencia entre sondeo y trap, las tres versiones de SNMP y cuál corresponde a un dispositivo de borde, cómo leer lo que el SBC expone a través de su MIB, y cómo conectar ProSBC a Zabbix, PRTG, SolarWinds o cualquier otra plataforma que hable SNMP. Para la cuestión más amplia de qué métricas de voz rastrear y cómo establecer umbrales, la guía de mejores prácticas de monitoreo VoIP cubre el lado estratégico; esta página se mantiene enfocada en SNMP.
Puertos SNMP: 161 y 162 explicados
SNMP utiliza dos puertos UDP bien conocidos, y distinguirlos es la base de todo lo que sigue. El puerto 161 es donde el agente en el dispositivo escucha las consultas entrantes de la estación de gestión. Cuando su NMS desea conocer el conteo actual de sesiones del SBC o el tiempo de actividad del sistema, envía una solicitud al puerto UDP 161 del SBC y lee la respuesta. El puerto 162 funciona en la dirección opuesta: es donde la estación de gestión escucha los trap e inform que los dispositivos le envían. Cuando el SBC necesita anunciar que acaba de ocurrir una conmutación por error, envía esa notificación al puerto UDP 162 del manager.
SNMP normalmente utiliza UDP (puertos 161 y 162), aunque el transporte TCP está definido para algunas implementaciones y despliegues especializados. El tráfico de monitoreo debe mantenerse liviano y no debe agregar carga ni latencia a un dispositivo que ya está ocupado procesando llamadas, por lo que SNMP acepta el pequeño riesgo de un paquete perdido a cambio de una sobrecarga mínima. Un sondeo perdido simplemente se reintenta en el siguiente intervalo, y las consecuencias de un trap perdido se manejan utilizando inform donde la entrega garantizada es importante.
Los valores 161 y 162 son los predeterminados registrados en la IANA, y casi todas las implementaciones los mantienen tal cual para que el autodescubrimiento del NMS funcione sin configuración especial. Sin embargo, no son inmutables. En ProSBC el destino del trap, incluido su puerto, es un campo configurable, por lo que usted puede dirigir las notificaciones a un manager que escuche en un puerto diferente al estándar 162 si su entorno lo requiere. La conclusión práctica para la planificación de firewall es que debe abrir el puerto UDP 161 entrante hacia el SBC desde su red de gestión para el sondeo, y el puerto UDP 162 entrante hacia su NMS desde el SBC para los trap. Dado que el SBC se encuentra en el perímetro, esas reglas deben limitar el origen a la subred de gestión en lugar de dejar los puertos abiertos al mundo.
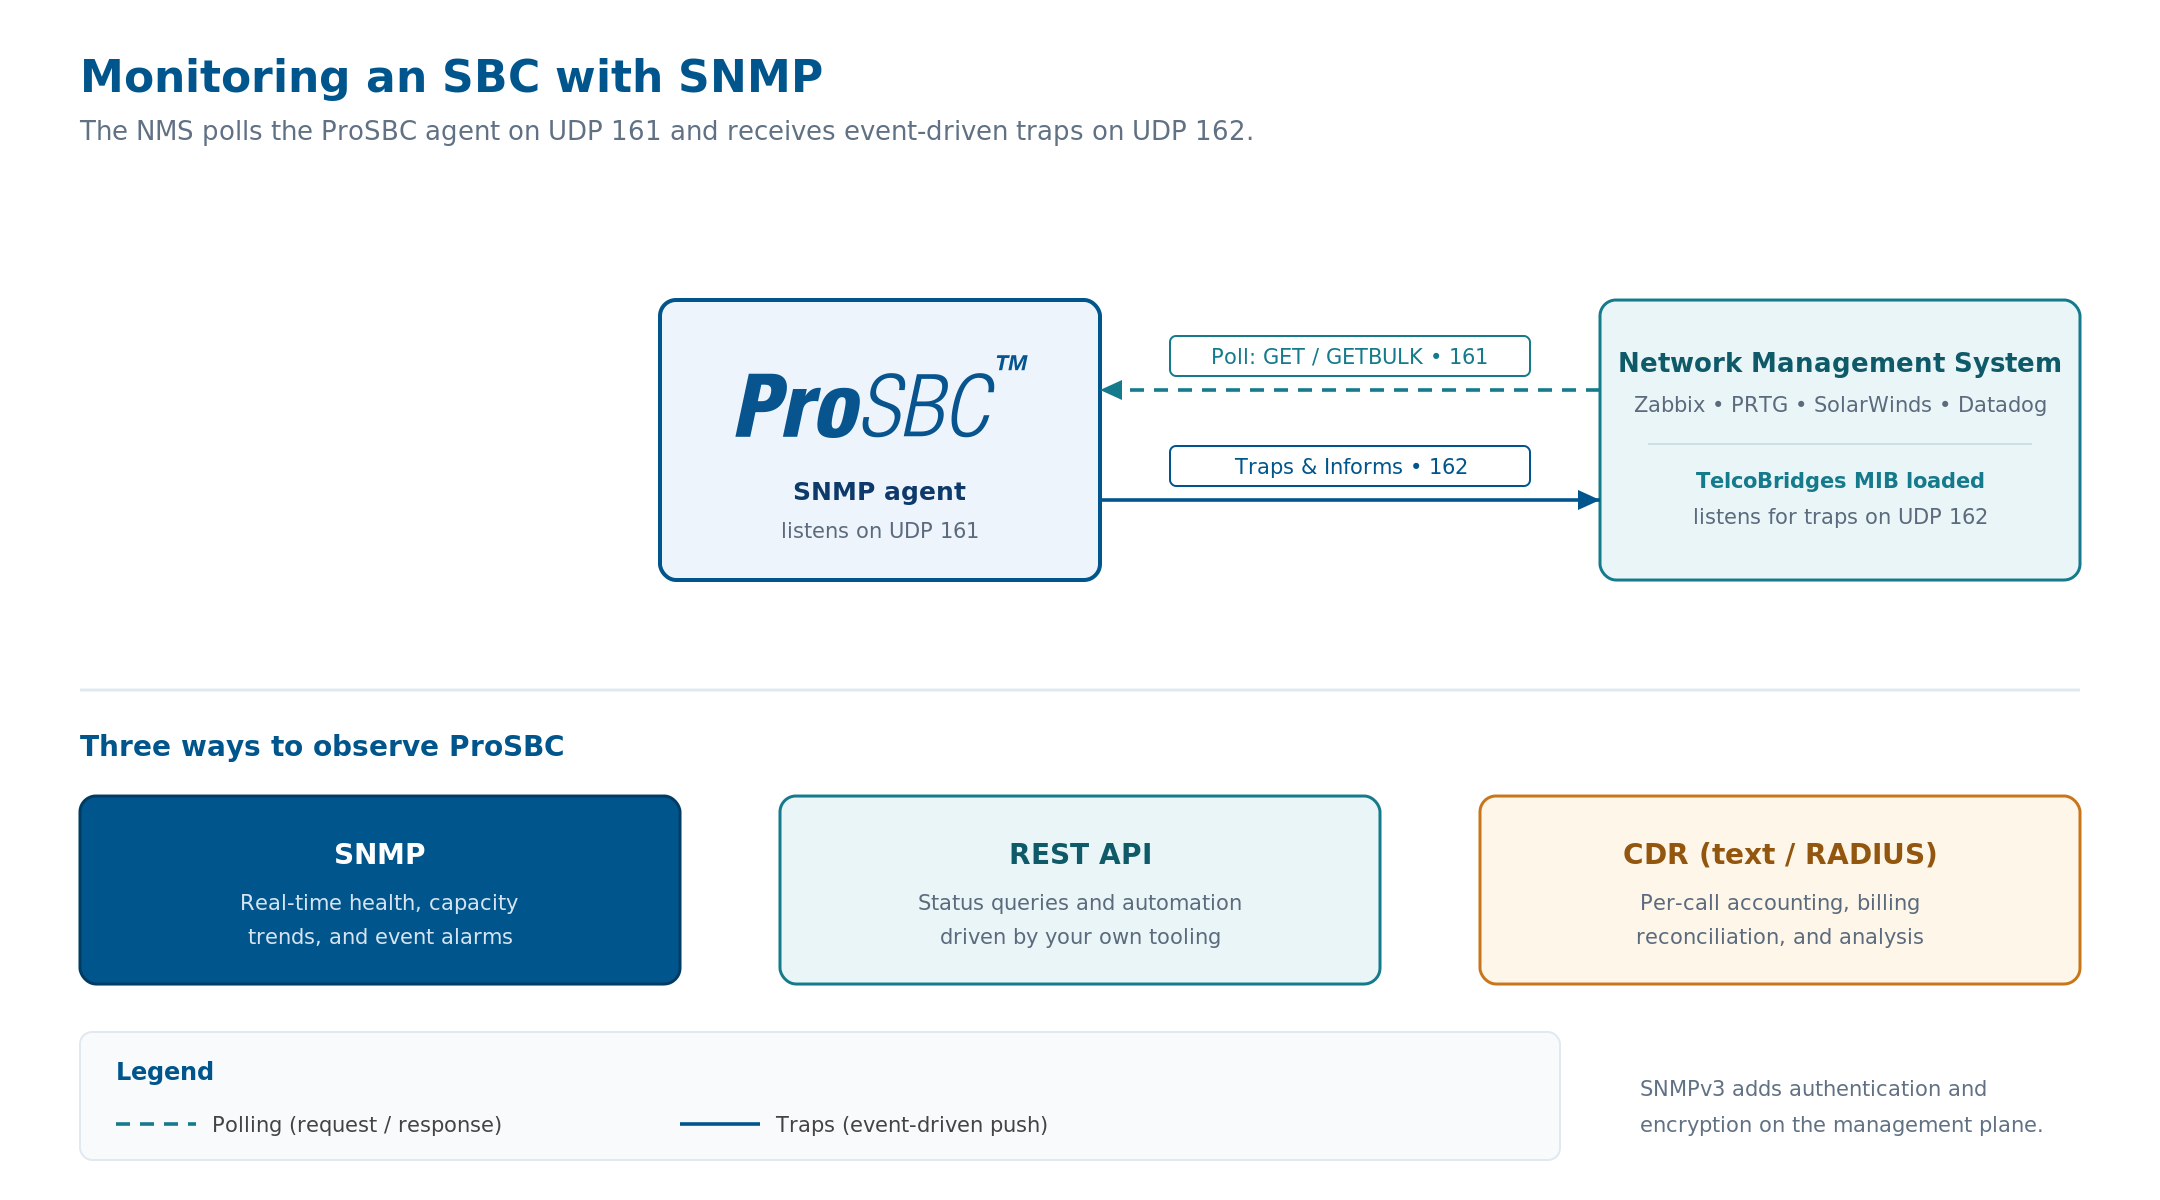
Topología de monitoreo SNMP para un SBC: el NMS sondea al agente ProSBC en el puerto UDP 161 y recibe trap basados en eventos en el puerto UDP 162. El MIB de TelcoBridges, cargado en el NMS, traduce los OID del agente en métricas con nombre. La REST API y la salida de CDR funcionan como canales separados para consultas de estado y contabilidad por llamada. Haga clic para ampliar.
Sondeo frente a trap: dos direcciones del monitoreo
SNMP mueve datos en dos direcciones, y una configuración de monitoreo saludable utiliza ambas. Comprender cuándo se adapta cada una es lo que separa un sistema de alertas ruidoso de uno en el que su equipo realmente confía.
Sondeo (polling) es cuando el manager solicita un valor al agente según un cronograma, por ejemplo cada 60 segundos. Es la forma en que usted construye los gráficos que muestran el conteo de sesiones, CPU, memoria y totales de registros a lo largo del tiempo. El sondeo le proporciona la línea base continua que hace posible la planificación de capacidad y le permite detectar una desviación gradual antes de que se convierta en una interrupción. Su limitación es la resolución: cualquier evento que ocurra y se resuelva dentro del intervalo de sondeo puede pasar completamente desapercibido, y reducir el intervalo para capturar eventos rápidos multiplica la carga de consultas en todos los dispositivos que usted monitorea.
Los trap invierten ese modelo haciendo que el agente envíe una notificación en el instante en que un evento se dispara, de modo que una conmutación por error o una violación de umbral llega a su NMS en tiempo real en lugar de esperar al próximo sondeo. Esto es lo que usted necesita para cualquier situación sensible al tiempo en una plataforma de voz. La contrapartida es que un trap estándar es de tipo “enviar y olvidar” sobre UDP, por lo que si el paquete se pierde, el evento simplemente desaparece. Los inform resuelven esto al requerir que el manager confirme la recepción, lo cual vale el viaje de ida y vuelta adicional para las alarmas que usted no puede permitirse perder.
En la práctica, usted sondea para tendencias y utiliza trap para incidentes. Sondee los contadores del SBC para alimentar paneles y reportes de capacidad, y configure trap para los eventos que demandan una respuesta humana inmediata. Depender únicamente del sondeo deja un punto ciego durante los segundos entre intervalos, y depender únicamente de los trap lo deja sin una línea base contra la cual interpretarlos.
Versiones de SNMP: v1, v2c y v3
Tres versiones de SNMP están en uso activo, y la diferencia entre ellas tiene que ver principalmente con la seguridad, lo cual importa mucho para un dispositivo expuesto en el borde de la red.
SNMPv1 ya no se recomienda para nuevas implementaciones. Se autentica con un community string y no ofrece cifrado, y su manejo limitado de errores y tamaños de contadores lo hacen inadecuado para los volúmenes de tráfico de operadores modernos.
SNMPv2c sigue ampliamente desplegado porque mantiene el modelo simple de community string mientras agrega contadores de 64 bits, la operación GETBULK más eficiente y el tipo de notificación inform. La desventaja es la misma que arrastra v1: el community string cruza la red en texto claro, por lo que cualquier persona que pueda capturar un paquete puede leerlo y reutilizarlo. Eso es aceptable dentro de una VLAN de gestión estrictamente controlada, y es genuinamente riesgoso en cualquier lugar donde un community string pueda ser interceptado.
SNMPv3 es la versión que corresponde a un controlador de borde de sesión. Reemplaza el community string con el modelo de seguridad basado en usuario (User-based Security Model), que proporciona autenticación por usuario (HMAC con SHA) y cifrado opcional de la carga útil (AES). Ejecutar v3 en su modo authPriv significa que tanto las credenciales como los datos de monitoreo están protegidos en el cable, que es exactamente la postura que usted desea para un dispositivo que se encuentra en el perímetro y reporta sobre tráfico de llamadas en vivo. ProSBC soporta ambos modelos: usted puede crear un community SNMPv1 o SNMPv2c donde una red interna endurecida lo haga práctico, o crear un usuario SNMPv3 donde se requieran autenticación y cifrado. El mismo enfoque de seguridad de borde que rige la seguridad del SBC en su conjunto se aplica al plano de gestión, y SNMPv3 es la forma de extenderlo allí.
Qué expone el SBC: lectura del MIB
Cada valor que un agente SNMP puede reportar tiene un OID, una dirección en notación decimal con puntos como 1.3.6.1.2.1.1.3.0 para el tiempo de actividad del sistema. Los OID están organizados como un árbol, con ramas estándar que todos los dispositivos comparten (los grupos de sistema e interfaces de MIB-2, por ejemplo) y una rama de empresa privada bajo 1.3.6.1.4.1 donde cada fabricante define sus propios objetos. Un MIB es el archivo que traduce esos números a nombres, para que su NMS pueda mostrar “tiempo de actividad del sistema” en lugar de una cadena de dígitos.
Para monitorear un SBC correctamente, usted carga dos tipos de MIB en su NMS. Los MIB estándar le dan los objetos universales de salud del dispositivo: tiempo de actividad, CPU, memoria, estado y rendimiento de interfaces de red, y datos similares a nivel de sistema que usted recopilaría de cualquier servidor. El MIB empresarial del fabricante le da los objetos específicos de la plataforma. Para ProSBC, el MIB de TelcoBridges es lo que su NMS necesita para nombrar y graficar los objetos específicos del SBC, y es lo primero que debe obtener cuando configure el monitoreo, ya que sin él los OID empresariales regresan como números sin etiquetar que su plataforma no puede identificar.
Los objetos que vale la pena monitorear en una plataforma de voz se agrupan en unas pocas categorías: salud del sistema (CPU, memoria, disco, tiempo de actividad), el estado de alta disponibilidad del nodo, conteos de sesiones activas y llamadas contra su capacidad licenciada, y totales de registros de endpoints. Estos son los valores que le indican si la plataforma está saludable y qué tan cerca opera de sus límites. Las métricas más profundas de calidad de llamada que interesan a los equipos de VoIP, como la relación de tomas con respuesta (ASR), el retardo post-marcación y el Mean Opinion Score (MOS), son parte de un panorama de monitoreo más amplio que combina SNMP con análisis de CDR y estadísticas de medios. La guía de mejores prácticas de monitoreo VoIP cubre cuáles de esas métricas priorizar y cómo establecer umbrales para ellas.
Mapeo de trap SNMP a incidentes operativos
Un trap solo es útil si se mapea claramente a una acción. El objetivo al diseñar sus alertas es que cada trap que active una notificación a un humano corresponda a algo que un humano realmente necesita hacer, porque un SBC que inunda el NMS con notificaciones de bajo valor entrena a su equipo a ignorar el canal que más debería importar. La tabla a continuación muestra el tipo de mapeo que funciona bien para una plataforma de voz.
| Señal SNMP | Qué suele significar | Respuesta operativa |
|---|---|---|
| Trap de conmutación por error (failover) de alta disponibilidad | El nodo en espera ha tomado el control del nodo activo | Notificar al guardia de turno de inmediato; investigar el nodo fallido antes de que el par quede expuesto a una segunda falla |
| Conteo de sesiones cercano a la capacidad licenciada | El tráfico se está acercando al techo de la implementación | Planificar capacidad ahora; un techo rígido descarta nuevas llamadas en lugar de degradarse gradualmente |
| Pico o colapso en el conteo de registros | Una inundación de registros, o una caída upstream que desconecta endpoints | Correlacionar con los registros de seguridad; una inundación es un posible ataque SIP, un colapso apunta hacia upstream |
| Interfaz caída o cambio de estado de enlace | Una ruta de red física o virtual se ha caído | Verificar la ruta antes de que el audio se vea afectado; el audio en un solo sentido a menudo comienza aquí |
| Umbral de recurso (CPU, memoria, disco) | El host está bajo presión y podría degradarse | Investigar la causa; la presión sostenida precede a los problemas de calidad |
El principio detrás del mapeo es que los trap impulsan incidentes mientras que el sondeo impulsa tendencias. Usted configura el SBC para que genere trap ante los cambios de estado que requieren una respuesta rápida, y se apoya en el historial de sondeo para entender qué estaba sucediendo en los minutos previos al trap. Cuando llega un trap de conmutación por error, los gráficos de sondeo de CPU, sesiones y rendimiento de interfaces que lo preceden son lo que convierte una alarma en bruto en un diagnóstico.
Conectar SNMP de ProSBC a su plataforma de monitoreo
Dado que ProSBC expone un agente SNMP estándar, la integración sigue el mismo patrón que cualquier otro dispositivo en su red. Cualquier plataforma que hable SNMP puede sondearlo, incluidos Zabbix, PRTG, SolarWinds y LibreNMS, así como Datadog a través de su integración SNMP. No hay un conector propietario que instalar en ninguno de los dos lados, que es precisamente el propósito de usar un protocolo estándar.
La configuración se realiza en cuatro pasos del lado de ProSBC. Primero, habilite el agente SNMP en los ajustes de sistema del portal web. Segundo, cree la credencial que utilizará el manager, ya sea un community SNMPv1 o SNMPv2c para una red interna endurecida o, preferiblemente, un usuario SNMPv3 con autenticación y cifrado. Tercero, cree un destino de trap apuntando a su NMS para que las notificaciones de eventos tengan adónde llegar. Cuarto, cargue el MIB de TelcoBridges en su NMS para que los OID sondeados y los trap entrantes se muestren como métricas con nombre y graficables en lugar de números sin procesar.
A partir de ahí, el trabajo es específico de cada plataforma en las formas habituales. En Zabbix usted importa el MIB, agrega el SBC como host SNMP y construye elementos y disparadores contra los OID que le interesen. En PRTG agrega sensores SNMP por métrica. En SolarWinds incorpora el nodo bajo gestión y selecciona los OID a graficar. En Datadog configura su integración SNMP con el perfil del dispositivo y las credenciales. En cada caso el SBC hace lo mismo: responde sondeos en el puerto 161 y envía trap al puerto 162. Las diferencias residen enteramente en cómo cada NMS modela y visualiza lo que recopila.
SNMP no es la única forma de observar ProSBC, y para algunas integraciones no es la más adecuada. La plataforma ofrece tres canales de monitoreo, y la elección correcta depende de lo que usted esté intentando hacer. Si prefiere no ejecutar la capa de recolección usted mismo, Monitoring as a Service es una opción gestionada que proporciona paneles, alertas basadas en umbrales a través de correo electrónico, Slack, Teams o Discord, análisis histórico y soporte experto sobre los mismos datos subyacentes.
SNMP, REST API y CDR: elegir el canal adecuado
SNMP es la herramienta correcta para la salud del dispositivo en tiempo real y las alarmas por umbral, pero es uno de tres canales mediante los cuales ProSBC expone datos operativos, y un panorama completo de monitoreo generalmente recurre a más de uno. Elegir el canal incorrecto para una tarea tiende a producir brechas o complejidad innecesaria.
| Canal | Mejor para | Cómo funciona |
|---|---|---|
| SNMP | Salud en tiempo real, tendencias de capacidad, alarmas basadas en eventos | El NMS sondea al agente en el puerto 161 y recibe trap en el puerto 162 |
| REST API | Consultas de estado y configuración desde sus propias herramientas | Su sistema emite solicitudes HTTP GET para estado y condición |
| Salida de CDR | Contabilidad por llamada, conciliación de facturación, análisis de calidad de llamada | El SBC escribe registros de detalle de llamada en formato texto o RADIUS |
El patrón en el que la mayoría de los operadores converge es usar SNMP para la vista continua de salud y capacidad, la REST API para verificaciones de estado programadas y automatización que reside dentro de sus propios sistemas, y los CDR para todo lo que debe reconstruirse por llamada después del hecho. Una opción por línea de comandos, el script tbstatus ejecutado por SSH, también está disponible para verificaciones rápidas durante la resolución de problemas. SNMP le indica que la plataforma está saludable y cuán cargada se encuentra; los CDR le indican qué sucedió en una llamada específica cuando necesita investigar una. Los dos responden preguntas diferentes, y usar cada uno para su fortaleza es más confiable que estirar uno para cubrir ambas.
El estado de alta disponibilidad es un buen ejemplo de dónde SNMP demuestra su valor. Una implementación 1+1 solo es tan buena como su conocimiento de cuál nodo está activo y si ha ocurrido una conmutación por error, y un trap SNMP en el evento de conmutación por error más el estado de alta disponibilidad sondeado le proporciona exactamente eso. El lado arquitectónico de ejecutar nodos redundantes se cubre en la guía de alta disponibilidad y conmutación por error.
Preguntas frecuentes
¿Qué puerto utiliza SNMP?
SNMP utiliza dos puertos UDP. El agente en el dispositivo monitoreado escucha en el puerto UDP 161 las consultas de sondeo de la estación de gestión, y la estación de gestión escucha en el puerto UDP 162 los trap e inform enviados por los dispositivos. Ambos son valores predeterminados de la IANA; el puerto de destino del trap es configurable en ProSBC si su entorno necesita un valor no estándar.
¿Debería usar SNMPv2c o SNMPv3 para un SBC?
Use SNMPv3 en un controlador de borde de sesión. SNMPv2c envía su community string en texto claro, lo cual solo es aceptable dentro de una red de gestión estrictamente controlada. SNMPv3 agrega autenticación por usuario y cifrado de la carga útil a través del modelo de seguridad basado en usuario (User-based Security Model), que es la postura apropiada para un dispositivo expuesto en el borde de la red. ProSBC soporta ambos, por lo que usted puede ajustar la versión al modelo de seguridad de su red.
¿Puedo monitorear ProSBC con Zabbix, PRTG o SolarWinds?
Sí. ProSBC expone un agente SNMP estándar, por lo que cualquier plataforma con capacidad SNMP puede sondearlo, incluidos Zabbix, PRTG, SolarWinds, LibreNMS y Datadog a través de su integración SNMP. La configuración es la misma que para cualquier dispositivo: habilitar el agente, configurar un community o un usuario SNMPv3, apuntar un destino de trap a su NMS y cargar el MIB de TelcoBridges para que las métricas se muestren con nombres.
¿Cuál es la diferencia entre un trap SNMP y un sondeo?
Un sondeo es cuando el manager solicita un valor al agente según un cronograma fijo, que es la forma en que usted construye gráficos de tendencias e historial de capacidad. Un trap es cuando el agente envía una notificación al manager en el instante en que ocurre un evento, que es la forma en que usted captura incidentes en tiempo real. Usted sondea para tendencias y utiliza trap para incidentes; una configuración completa emplea ambos.
¿Dónde obtengo el MIB de ProSBC?
El MIB de TelcoBridges define los objetos empresariales específicos que ProSBC reporta, y usted lo carga en su NMS para que los OID sondeados y los trap entrantes aparezcan como métricas con nombre. Está disponible a través del soporte y la documentación de TelcoBridges, y obtenerlo es el primer paso cuando usted configura el monitoreo SNMP, ya que sin él los OID empresariales regresan como números sin etiquetar.
¿En qué se diferencia el monitoreo SNMP del monitoreo por CDR o REST API?
SNMP es para la salud del dispositivo en tiempo real, tendencias de capacidad y alarmas basadas en eventos. La REST API es para consultas de estado y automatización impulsada por sus propias herramientas. Los CDR son para contabilidad por llamada, conciliación de facturación y análisis de llamadas después del hecho. SNMP le indica que la plataforma está saludable y cuán cargada se encuentra; los CDR le indican qué sucedió en una llamada individual. La mayoría de los operadores utiliza los tres según sus respectivas fortalezas.
Monitoree su borde de voz con ProSBC
SNMP es la forma en que un controlador de borde de sesión se integra al mismo panorama operativo que el resto de su red. ProSBC incluye un agente SNMP estándar con soporte para SNMPv1, SNMPv2c y SNMPv3 y destinos de trap configurables, por lo que se integra en Zabbix, PRTG, SolarWinds o cualquier plataforma con capacidad SNMP sin un conector propietario. Junto con SNMP, la REST API y la salida de CDR completan una pila de monitoreo integral para salud en tiempo real, automatización y contabilidad por llamada.
Si prefiere que la capa de monitoreo se ejecute por usted, Monitoring as a Service proporciona paneles, alertas por umbral y soporte experto sobre los mismos datos. Y si desea cobertura operativa completa de la plataforma, Managed Service incluye alta disponibilidad 1+1, soporte 24/7 y monitoreo continuo en la infraestructura de su elección.
¿Prefiere evaluar por su cuenta primero? Inicie su prueba gratuita de 30 días.