Mean Opinion Score (MOS): o que e como o SBC mantém a qualidade de voz
Mais cedo ou mais tarde, todo operador de voz precisa responder a uma pergunta direta: qual a qualidade do áudio, em um número? Mean Opinion Score é esse número. Quando um cliente diz que a chamada “ficou ruim”, MOS é como você transforma isso em algo que pode ser medido, rastreado e discutido com uma operadora.
Neste artigo, vamos explicar o que MOS significa e o que a escala representa, de onde a pontuação surgiu originalmente, as três formas diferentes de medi-la hoje, o que conta como uma boa pontuação, e onde um session border controller (SBC) se encaixa na produção dela. Se você opera infraestrutura de voz e lida com chamados de qualidade de chamada, MOS é a linguagem comum que conecta o que um ouvinte escuta ao que sua rede está fazendo.

O que significa MOS e o que a escala representa
MOS significa Mean Opinion Score. É a classificação padrão de qualidade de voz percebida, expressa em uma escala de cinco pontos definida pelo ITU-T: 5 é excelente, 4 é bom, 3 é razoável, 2 é ruim e 1 é péssimo. Na prática, a pontuação raramente é um número inteiro, então você geralmente verá valores como 4.2 ou 3.6.
O número no qual a maioria dos operadores se ancora é 4.0. Um MOS igual ou acima de 4.0 é considerado toll quality, o padrão de uma chamada telefônica tradicional limpa, e é o objetivo de qualquer serviço de voz corporativo. Pontuações entre 3.5 e 4.0 são aceitáveis, mas perceptivelmente comprimidas ou afetadas pela rede. Abaixo de aproximadamente 3.5, os usuários começam a reclamar, e abaixo de 3.0 uma chamada é difícil de manter.
A razão pela qual MOS é uma pontuação perceptual, e não uma medição puramente de engenharia, importa para tudo o que segue. Ela foi projetada para capturar o que um humano realmente ouve, que é exatamente por que a pontuação começou sua vida como um teste de escuta.
De onde vem o MOS: teste subjetivo P.800
O MOS original é uma medição subjetiva, definida na Recomendação ITU-T P.800. Um painel de ouvintes escuta um conjunto de amostras de áudio sob condições controladas e classifica cada uma de 1 a 5 usando o método Absolute Category Rating. A pontuação publicada é a média aritmética dessas opiniões individuais, de onde vem o nome literalmente: a média (mean) das pontuações de opinião (opinion scores) dos ouvintes.
Este método é o padrão ouro porque mede a percepção diretamente. Nenhum algoritmo precisa adivinhar o que uma pessoa acharia, porque pessoas reais fizeram a avaliação. Sua fraqueza é a praticidade. Montar um painel de escuta é lento e caro, e só pode pontuar amostras gravadas após o fato. Você não pode executar um teste P.800 na chamada ao vivo sobre a qual um cliente está reclamando agora. Essa lacuna é o que empurrou a indústria para medir MOS por máquina.
De subjetivo a objetivo: PESQ e POLQA
Para aproximar um painel de escuta sem as pessoas, o ITU-T padronizou algoritmos de pontuação objetiva. PESQ (Perceptual Evaluation of Speech Quality, ITU-T P.862) e seu sucessor POLQA (Perceptual Objective Listening Quality Analysis, ITU-T P.863) funcionam por comparação: você alimenta o algoritmo com uma amostra de referência limpa e a amostra degradada que saiu do outro lado da rede, e ele modela como um ouvido e cérebro humano perceberiam a diferença, produzindo uma pontuação similar ao MOS.
Estes são métodos intrusivos de referência completa. “Referência completa” significa que precisam do sinal original não degradado para comparação, e “intrusivo” significa que injetam um sinal de teste conhecido no caminho em vez de escutar o tráfego ao vivo. Isso os torna excelentes para testes de laboratório, avaliação de codec e sondagens ativas programadas, onde você controla ambas as pontas. Também significa que não são a ferramenta para pontuar passivamente cada chamada ao vivo conforme acontece, porque chamadas reais não vêm com uma cópia de referência anexada.
Estimando MOS em produção: o E-Model e R-Factor
O método que pontua chamadas ao vivo é o E-model, definido no ITU-T G.107. Em vez de comparar amostras de áudio, ele calcula a qualidade a partir dos parâmetros de rede e codec da própria chamada. O E-model produz um fator de classificação de transmissão, o R-factor, em uma escala de aproximadamente 0 a 100, e então mapeia esse valor R para um MOS estimado.
O R-factor é construído a partir das degradações que prejudicam uma chamada: o codec em uso, perda de pacotes, jitter (que se torna perda efetiva quando pacotes chegam tarde demais para serem reproduzidos) e atraso unidirecional. Cada um destes é um assunto por si só, e a perda de pacotes em particular é uma das maiores entradas individuais para uma queda na pontuação. Se você quer o lado diagnóstico dessas degradações, o guia de troubleshooting VoIP explica como cada uma aparece em uma chamada. Para MOS, o ponto é que o E-model agrupa todas em um único número estimado.
A vantagem é decisiva para operadores: o E-model é passivo e não precisa de sinal de referência, então pode produzir uma estimativa contínua de qualidade para cada chamada em andamento. É por isso que o MOS que você vê em um dashboard de monitoramento é quase sempre uma estimativa do E-model, não uma pontuação de painel.
Tetos de codec: por que uma chamada nunca supera seu codec
Cada codec define um MOS máximo que uma chamada usando-o pode alcançar. A compressão e codificação que o codec aplica estabelecem um teto, e tudo o que a rede faz a partir daí só pode subtrair dele. Uma rede sem falhas não consegue empurrar uma chamada acima do teto de seu codec.
Figuras de referência comumente citadas colocam o G.711 narrowband na faixa baixa a média dos 4, o G.729 narrowband em torno de 4.0 (mais baixo, porque comprime mais forte), e codecs wideband como G.722 e Opus mais acima ainda, já que carregam uma faixa de áudio mais ampla que os ouvintes classificam como mais clara. Os números exatos variam por teste, mas a classificação é consistente e a lição é prática: o codec que você negocia define o teto, e gerenciar a rede protege a margem abaixo dele. A comparação G.711 vs G.729 detalha os trade-offs que definem esses tetos.
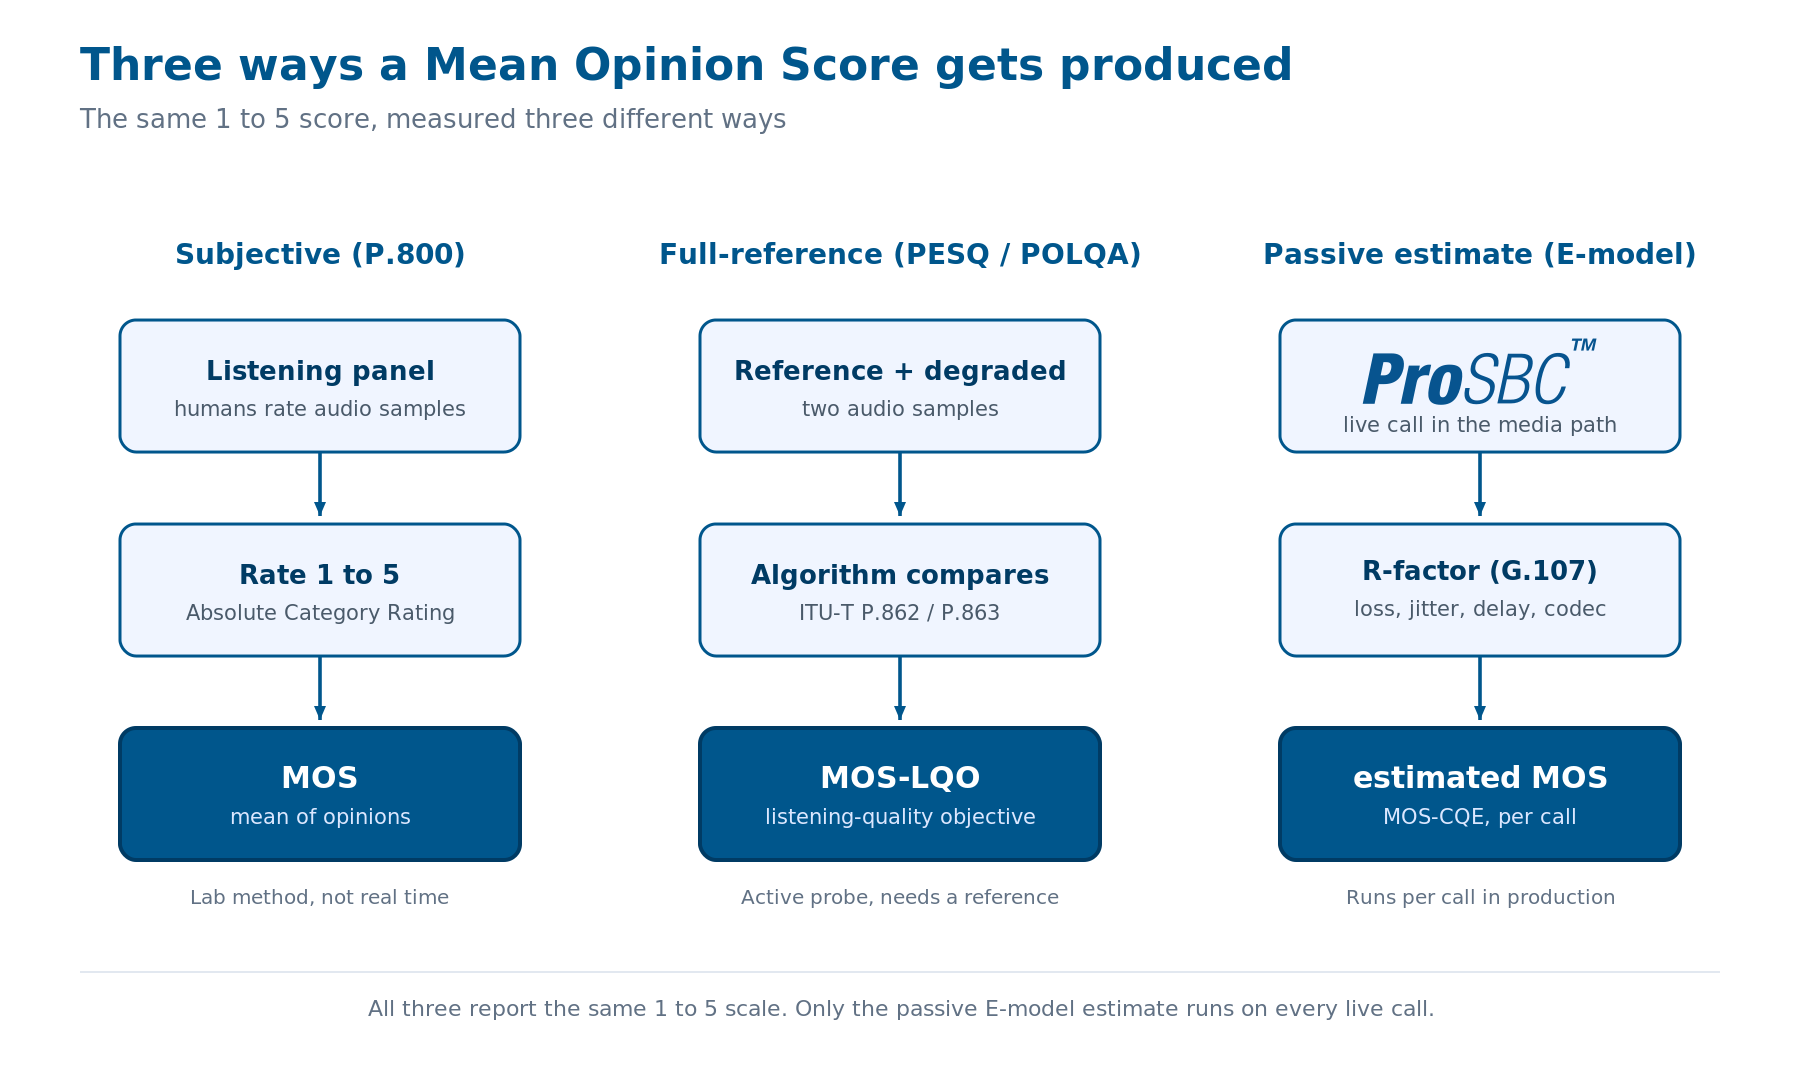
A mesma pontuação de 1 a 5 é produzida de três formas diferentes. Apenas a estimativa passiva do E-model é comumente usada por chamada em produção, onde é calculada a partir de estatísticas ao vivo de rede e mídia. Clique para ampliar.
Como um SBC mede e ajuda a manter o MOS
Um session border controller ganha seu lugar aqui porque, quando o media anchoring está habilitado, ele pode observar a mídia diretamente e coletar informações de qualidade por chamada. O RTP transporta o áudio, e seu protocolo complementar RTCP transporta estatísticas de qualidade de volta pela chamada. O formato de relatório estendido, RTCP-XR definido na RFC 3611, adiciona um bloco de relatório de métricas VoIP que pode transportar um MOS estimado junto com valores de perda e atraso, para que os dados de qualidade trafeguem com a chamada em vez de serem reconstruídos depois.
Como um SBC opera como um back-to-back user agent, terminando totalmente a mídia em cada lado, ele pode observar a qualidade por chamada e manter baselines por codec, e pode identificar em qual perna da chamada está o problema. Localizar uma queda de qualidade em um segmento de rede específico é o coração do troubleshooting de qualidade de chamada, e a prática mais ampla de rastrear MOS, jitter, latência e perda de pacotes juntos é coberta no guia de melhores práticas de monitoramento VoIP.
O ProSBC expõe isso diretamente. Ele produz pontuações MOS por chamada junto com valores de jitter e perda de pacotes, e os disponibiliza via SNMP e saída CDR, para que os dados fluam para qualquer plataforma de monitoramento que você já utiliza. Para inspeção detalhada, o ProSBC também suporta captura de pacotes ao vivo e rastreamento completo de chamadas SIP e RTP, permitindo que um engenheiro extraia os pacotes reais por trás de uma pontuação baixa. A TelcoBridges possui mais de vinte anos de implantação SIP e mídia por trás dessa capacidade, e o ProSBC lida com mídia em escala de operadora.
Uma ressalva honesta: um SBC estima e localiza a qualidade, não a fabrica. Ele não pode criar largura de banda que não existe ou recuperar áudio que uma rede de terceiros já descartou. O que ele oferece é um MOS preciso por chamada e a evidência para apontar o segmento responsável, que é a maior parte do que resolver um chamado de qualidade realmente exige.
Perguntas frequentes
O que significa MOS?
MOS significa Mean Opinion Score, a classificação padrão de 1 a 5 da qualidade de voz percebida definida pelo ITU-T, onde 5 é excelente e 1 é ruim.
Qual é uma boa pontuação MOS para VoIP?
Um MOS de 4.0 ou acima é considerado toll quality e é o objetivo para voz corporativa. Entre 3.5 e 4.0 é aceitável, mas perceptivelmente afetado, e abaixo de aproximadamente 3.5 os usuários começam a reclamar.
O MOS é avaliado por uma pessoa real ou por um algoritmo?
Ambos, dependendo do método. A pontuação original P.800 vem de um painel de ouvintes humanos. PESQ e POLQA são algoritmos que aproximam um painel comparando uma referência a uma amostra degradada, e o E-model estima o MOS a partir de parâmetros de rede sem nenhuma escuta.
Qual é a diferença entre MOS, PESQ e POLQA?
MOS é a pontuação em si. PESQ (ITU-T P.862) e POLQA (ITU-T P.863) são dois algoritmos objetivos que produzem um valor similar ao MOS comparando um sinal de referência conhecido com a saída degradada, sendo POLQA o padrão mais recente que também lida com áudio wideband.
Um SBC pode melhorar o MOS?
Um SBC não pode aumentar a qualidade do áudio que uma rede de terceiros já degradou. Ele mede o MOS por chamada, localiza o problema em uma perna específica e ajuda a prevenir degradação autoinfligida, que é como ele protege a pontuação que você tem em vez de inventar uma maior.
Conclusão
MOS é um único número representando um julgamento humano, e sua credibilidade vem inteiramente da metodologia por trás dele. Uma pontuação de painel sob P.800, uma pontuação de algoritmo de referência completa do PESQ ou POLQA, e uma estimativa passiva do E-model são todas chamadas de MOS, mas são produzidas de formas muito diferentes, e saber qual você está olhando diz o quanto confiar nela e como agir com base nela. Para operações ao vivo, a estimativa do E-model transportada no RTCP é o número que importa, e obtê-la com precisão, por chamada, é onde a borda da rede faz seu trabalho.
Mantenha e comprove a qualidade de voz com o ProSBC
Quando um chamado de qualidade de chamada chega à sua mesa, um MOS por chamada medido no caminho da mídia é o que transforma “ficou ruim” em um fato sobre o qual você pode agir. O ProSBC produz pontuações MOS por chamada junto com valores de jitter e perda de pacotes e os expõe via SNMP e CDR, para que fluam para a plataforma de monitoramento que você já utiliza. Como um back-to-back user agent completo, ele observa a qualidade de mídia em cada perna de forma independente, e suporta captura de pacotes ao vivo e rastreamento completo de chamadas SIP e RTP quando você precisa inspecionar os pacotes por trás de uma pontuação.
O ProSBC escala para 60.000 sessões por servidor a partir de apenas $1,40 por sessão por ano, e você pode comprovar tudo isso por conta própria no ProSBC Lab gratuito e permanente, uma licença self-service de três sessões que leva cerca de vinte minutos para configurar. Se você prefere ter os dashboards monitorados por você, o Monitoring as a Service é construído sobre os mesmos dados por chamada. Para o panorama completo, o guia de session border controller cobre tudo o que um SBC faz na borda da rede.
Prefere avaliar por conta própria primeiro? Inicie seu teste gratuito de 30 dias.