SNMP para monitoramento de SBC e VoIP: portas, MIBs e boas práticas operacionais
Como o SNMP funciona na prática em infraestrutura de voz: quais portas transportam o quê, como ler a MIB do SBC, quando usar polling ou aguardar traps, e como integrar tudo na plataforma de monitoramento que você já utiliza.
SNMP (Simple Network Management Protocol) é a linguagem comum que as plataformas de gerenciamento de rede utilizam, e um Controlador de Borda de Sessão (SBC) posicionado na borda da rede de voz é mais um dispositivo que deve reportar nos mesmos dashboards que seus roteadores, switches e servidores. O protocolo é de propósito geral, mas a forma como você o aplica a uma plataforma de voz tem características próprias: os contadores que importam são contadores de chamadas e registros, os alarmes que despertam você são failovers de Alta Disponibilidade (HA) e ataques na camada SIP, e os riscos de segurança são maiores porque o dispositivo fica no perímetro da rede.
Se você é um engenheiro responsável por manter a infraestrutura de voz saudável, este artigo orienta você pelo SNMP do ponto de vista operacional: as portas em que ele opera e o porquê, a diferença entre polling e traps, as três versões do SNMP e qual delas pertence a um dispositivo de borda, como interpretar o que o SBC expõe através da sua MIB, e como conectar o ProSBC ao Zabbix, PRTG, SolarWinds ou qualquer outra plataforma que fale SNMP. Para a questão mais ampla de quais métricas de voz monitorar e como definir thresholds, o guia de boas práticas de monitoramento VoIP cobre o lado estratégico; esta página foca no SNMP em si.

Portas SNMP: 161 e 162 explicadas
O SNMP utiliza duas portas UDP bem conhecidas, e mantê-las claras é a base para tudo que vem a seguir. A porta 161 é onde o agente no dispositivo escuta consultas da estação de gerenciamento. Quando seu NMS quer saber a contagem de sessões atual ou o uptime do SBC, ele envia uma requisição para UDP 161 no SBC e lê a resposta. A porta 162 opera na direção oposta: é onde a estação de gerenciamento escuta traps e informs que os dispositivos enviam para ela. Quando o SBC precisa anunciar que um failover acabou de acontecer, ele envia essa notificação para UDP 162 no manager.
O SNMP normalmente usa UDP (portas 161 e 162), embora o transporte TCP esteja definido para algumas implementações e implantações especializadas. O tráfego de monitoramento precisa permanecer leve e não deve adicionar carga ou latência a um dispositivo que já está ocupado processando chamadas, então o SNMP aceita o pequeno risco de um pacote perdido em troca de overhead mínimo. Um poll perdido simplesmente é repetido no próximo intervalo, e as consequências de um trap perdido são tratadas usando informs onde a entrega garantida é importante.
Os valores 161 e 162 são os padrões registrados na IANA, e quase toda implantação os mantém inalterados para que o auto-discovery do NMS funcione sem configuração especial. Eles não são imutáveis, contudo. No ProSBC, o destino do trap, incluindo sua porta, é um campo configurável, permitindo direcionar notificações para um manager escutando em uma porta diferente da 162 padrão, se seu ambiente exigir. A conclusão prática para planejamento de firewall é que você abre UDP 161 de entrada para o SBC a partir da sua rede de gerenciamento para polling, e UDP 162 de entrada para o seu NMS a partir do SBC para traps. Como o SBC fica no perímetro, essas regras devem restringir a origem à sub-rede de gerenciamento em vez de deixar as portas abertas para o mundo.
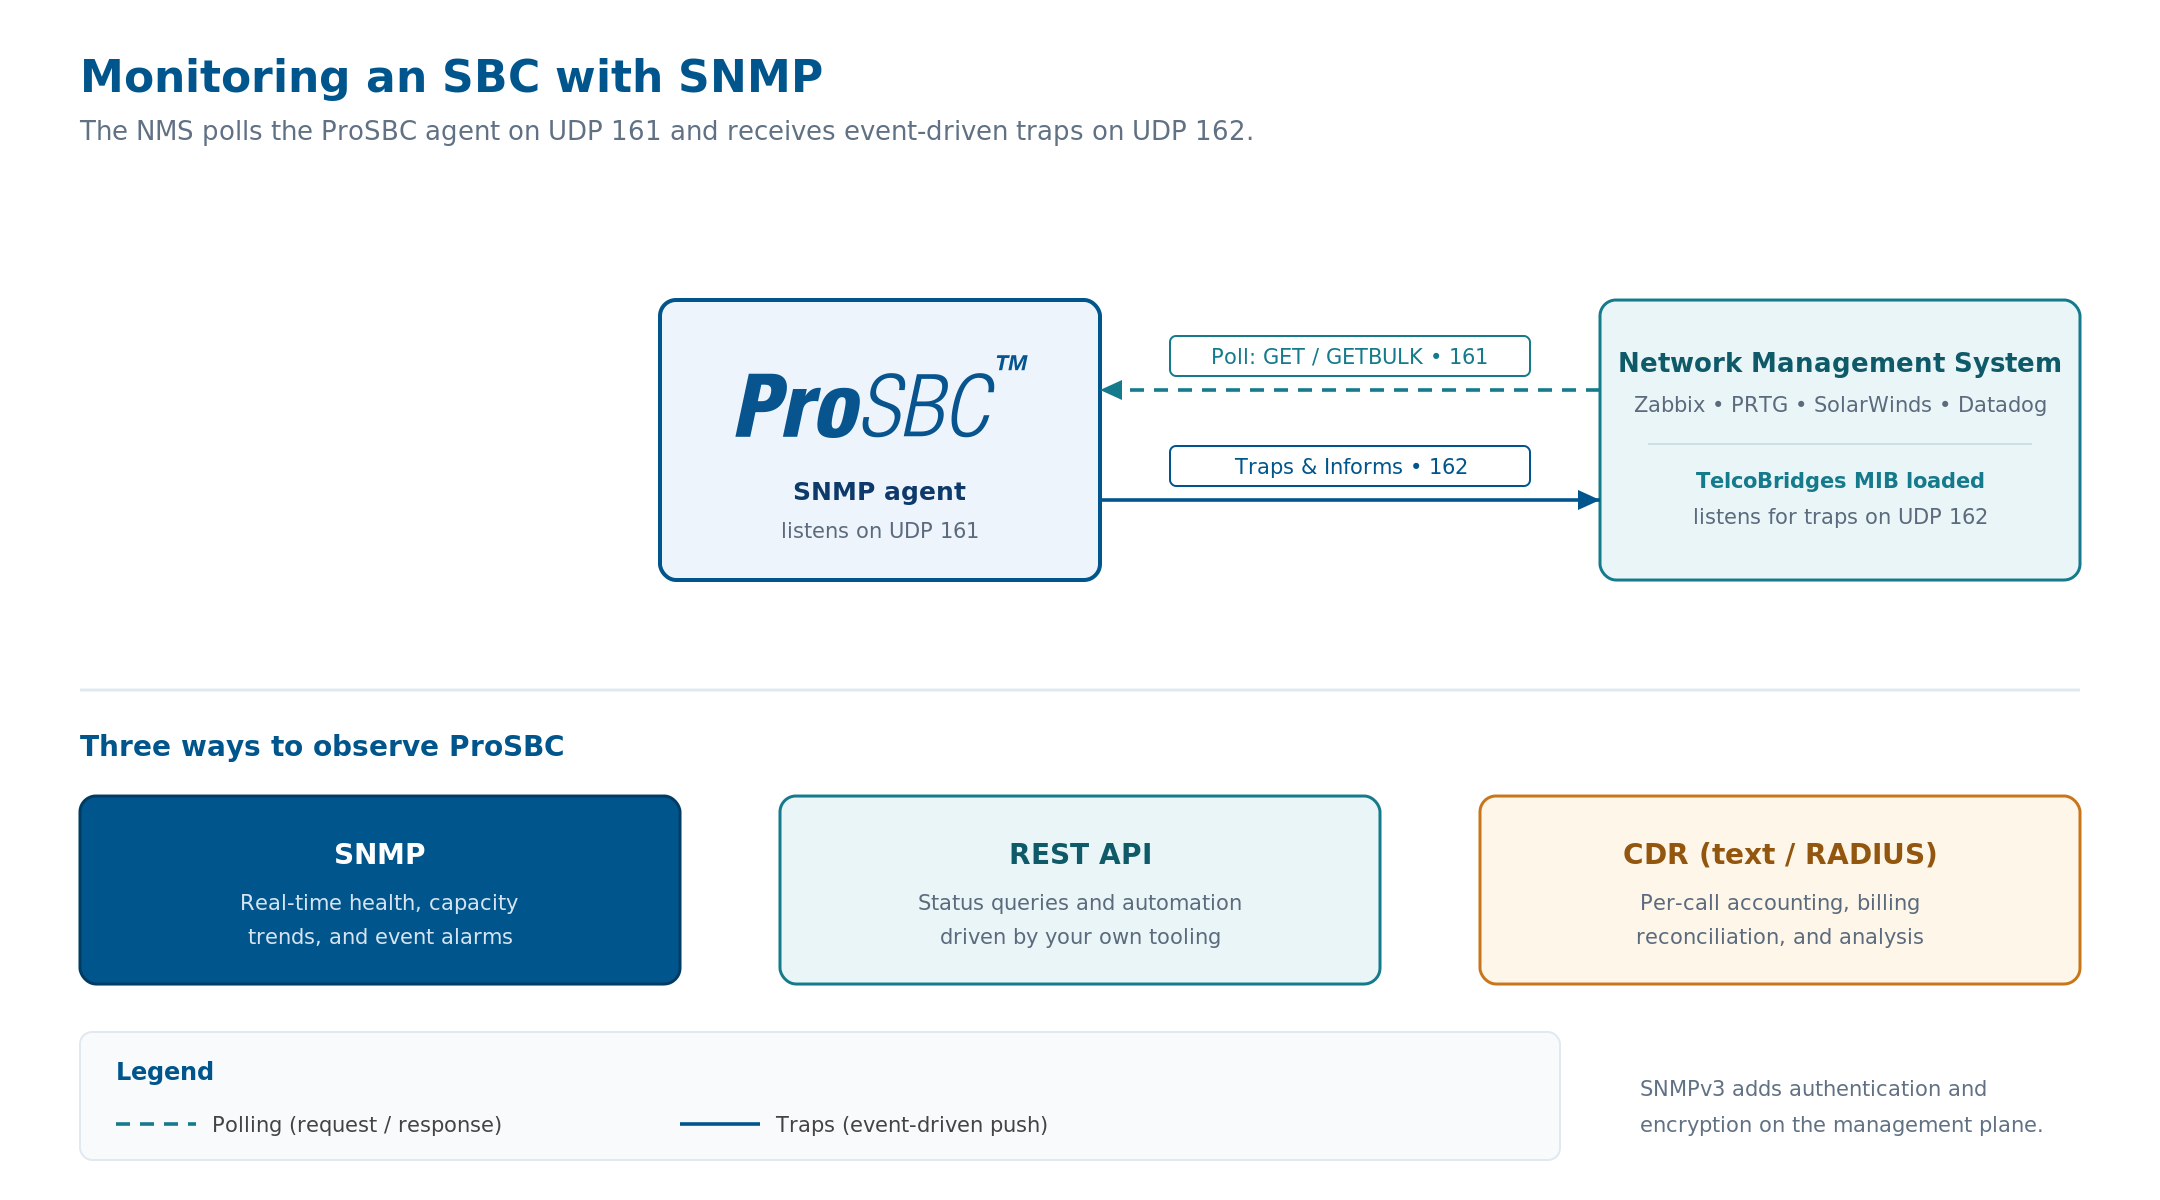
Topologia de monitoramento SNMP para um SBC: o NMS faz polling no agente ProSBC na UDP 161 e recebe traps orientados a eventos na UDP 162. A MIB da TelcoBridges, carregada no NMS, traduz os OIDs do agente em métricas nomeadas. REST API e saída de CDR operam como canais separados para consultas de status e contabilização por chamada. Clique para ampliar.
Polling versus traps: duas direções de monitoramento
O SNMP move dados em duas direções, e uma configuração de monitoramento saudável usa ambas. Entender quando cada uma se aplica é o que separa um sistema de alertas ruidoso de um em que sua equipe realmente confia.
Polling é o manager consultando o agente por um valor em um intervalo programável, digamos a cada 60 segundos. É assim que você constrói os gráficos que mostram contagem de sessões, CPU, memória e totais de registro ao longo do tempo. Polling fornece a linha de base contínua que torna o planejamento de capacidade possível e permite identificar uma tendência lenta antes que se torne uma interrupção. Sua limitação é a resolução: qualquer coisa que acontece e se resolve dentro do intervalo de polling pode ser completamente perdida, e diminuir o intervalo para capturar eventos rápidos multiplica a carga de consultas em cada dispositivo monitorado.
Traps invertem esse modelo fazendo o agente enviar uma notificação no instante em que um evento dispara, para que um failover ou uma violação de threshold chegue ao seu NMS em tempo real em vez de esperar pelo próximo poll. Isso é o que você quer para qualquer coisa sensível ao tempo em uma plataforma de voz. A contrapartida é que um trap padrão é fire-and-forget sobre UDP, então se o pacote for perdido, o evento simplesmente desaparece. Informs resolvem isso exigindo que o manager confirme o recebimento, o que vale o round trip extra para os alarmes que você não pode se dar ao luxo de perder.
Na prática, você faz polling para tendências e configura traps para incidentes. Faça polling nos contadores do SBC para alimentar dashboards e relatórios de capacidade, e configure traps para os eventos que exigem resposta humana imediata. Depender apenas de polling deixa um ponto cego durante os segundos entre intervalos, e depender apenas de traps deixa você sem uma linha de base para interpretá-los.
Versões do SNMP: v1, v2c e v3
Três versões do SNMP estão em uso ativo, e a diferença entre elas é principalmente sobre segurança, o que importa muito para um dispositivo exposto na borda da rede.
SNMPv1 não é mais recomendado para novas implantações. Ele autentica com uma community string e não oferece criptografia, e seu tratamento limitado de erros e tamanhos de contadores o tornam inadequado para volumes de tráfego de operadoras modernas.
SNMPv2c permanece amplamente implantado porque mantém o modelo simples de community string enquanto adiciona contadores de 64 bits, a operação mais eficiente GETBULK e o tipo de notificação inform. O problema é o mesmo do v1: a community string cruza a rede em texto puro, então qualquer pessoa que possa capturar um pacote pode lê-la e reutilizá-la. Isso é aceitável dentro de uma VLAN de gerenciamento controlada, e é genuinamente arriscado em qualquer lugar onde a community string possa ser interceptada.
SNMPv3 é a versão que pertence a um SBC. Ele substitui a community string pelo User-based Security Model, que fornece autenticação por usuário (HMAC com SHA) e criptografia opcional do payload (AES). Executar v3 no modo authPriv significa que tanto as credenciais quanto os dados de monitoramento são protegidos no fio, que é exatamente a postura que você quer para um dispositivo no perímetro que reporta tráfego de chamadas ao vivo. O ProSBC suporta ambos os modelos: você pode criar uma community SNMPv1 ou SNMPv2c onde uma rede interna endurecida torna isso prático, ou criar um usuário SNMPv3 onde autenticação e criptografia são necessárias. O mesmo pensamento de segurança de borda que governa a segurança do SBC como um todo se aplica ao plano de gerenciamento, e o SNMPv3 é como você o estende para lá.
O que o SBC expõe: lendo a MIB
Cada valor que um agente SNMP pode reportar tem um OID, um endereço em notação decimal pontilhada como 1.3.6.1.2.1.1.3.0 para o uptime do sistema. Os OIDs são organizados como uma árvore, com ramos padrão que todo dispositivo compartilha (os grupos de sistema e interface MIB-2, por exemplo) e um ramo de empresa privada sob 1.3.6.1.4.1 onde cada fabricante define seus próprios objetos. Uma MIB é o arquivo que traduz esses números em nomes, para que seu NMS possa exibir “uptime do sistema” em vez de uma string de dígitos.
Para monitorar um SBC adequadamente, você carrega dois tipos de MIB no seu NMS. As MIBs padrão fornecem os objetos universais de saúde do dispositivo: uptime, CPU, memória, status e throughput de interfaces de rede, e dados semelhantes no nível de sistema que você coletaria de qualquer servidor. A MIB enterprise do fabricante fornece os objetos específicos da plataforma. Para o ProSBC, a MIB da TelcoBridges é o que seu NMS precisa para nomear e criar gráficos dos objetos específicos do SBC, e é a primeira coisa a obter quando você configura o monitoramento, já que sem ela os OIDs enterprise retornam como números brutos que sua plataforma não consegue rotular.
Os objetos que vale a pena monitorar em uma plataforma de voz se dividem em alguns grupos: saúde do sistema (CPU, memória, disco, uptime), o estado de alta disponibilidade do nó, contagens de sessões ativas e chamadas contra sua capacidade licenciada, e totais de registro de endpoints. Esses são os valores que indicam se a plataforma está saudável e quão perto ela está operando dos seus limites. As métricas mais profundas de qualidade de chamada que equipes VoIP valorizam, como taxa de atendimento-ocupação (ASR), atraso pós-discagem e Mean Opinion Score (MOS), fazem parte de um quadro de monitoramento mais amplo que combina SNMP com análise de Registro de Detalhe de Chamada (CDR) e estatísticas de mídia. O guia de boas práticas de monitoramento VoIP cobre quais dessas métricas priorizar e como definir thresholds contra elas.
Mapeando traps SNMP para incidentes operacionais
Um trap só é útil se mapear claramente para uma ação. O objetivo ao projetar seus alertas é que cada trap que aciona um humano corresponda a algo que um humano realmente precisa fazer, porque um SBC que inunda o NMS com notificações de baixo valor treina sua equipe a ignorar o canal que deveria importar mais. A tabela abaixo mostra o tipo de mapeamento que funciona bem para uma plataforma de voz.
| Sinal SNMP | O que geralmente significa | Resposta operacional |
|---|---|---|
| Trap de failover HA | O nó standby assumiu o controle do nó ativo | Acione o plantão imediatamente; investigue o nó que falhou antes que o par fique exposto a uma segunda falha |
| Contagem de sessões próxima da capacidade licenciada | O tráfego está se aproximando do teto da implantação | Planeje capacidade agora; um teto rígido descarta novas chamadas em vez de degradar gradualmente |
| Pico ou colapso na contagem de registros | Um flood de registros, ou uma interrupção upstream derrubando endpoints | Correlacione com logs de segurança; um flood é um possível ataque SIP, um colapso aponta para upstream |
| Interface inativa ou mudança de estado de link | Um caminho de rede físico ou virtual caiu | Verifique o caminho antes que a mídia seja afetada; áudio unidirecional frequentemente começa aqui |
| Threshold de recurso (CPU, memória, disco) | O host está sob pressão e pode degradar | Investigue a causa; pressão sustentada precede problemas de qualidade |
O princípio por trás do mapeamento é que traps geram incidentes enquanto polling gera tendências. Você configura o SBC para emitir traps nas mudanças de estado que precisam de resposta rápida, e utiliza o histórico de polling para entender o que estava acontecendo nos minutos antes do trap disparar. Quando um trap de failover chega, os gráficos de polling de CPU, sessões e throughput de interface que antecederam são o que transforma um alarme bruto em um diagnóstico.
Integrando o SNMP do ProSBC na sua plataforma de monitoramento
Como o ProSBC expõe um agente SNMP padrão, a integração segue o mesmo padrão de qualquer outro dispositivo na sua rede. Qualquer plataforma que fale SNMP pode fazer polling nele, incluindo Zabbix, PRTG, SolarWinds e LibreNMS, assim como Datadog através da sua integração SNMP. Não há conector proprietário para instalar em nenhum dos lados, que é justamente o objetivo de usar um protocolo padrão.
A configuração envolve quatro passos no lado do ProSBC. Primeiro, habilite o agente SNMP nas configurações de sistema do portal web. Segundo, crie a credencial que o manager usará, seja uma community SNMPv1 ou SNMPv2c para uma rede interna endurecida ou, preferencialmente, um usuário SNMPv3 com autenticação e criptografia. Terceiro, crie um destino de trap apontando para o seu NMS para que as notificações de eventos tenham para onde ir. Quarto, carregue a MIB da TelcoBridges no seu NMS para que os OIDs consultados e os traps recebidos exibam métricas nomeadas e gráficas em vez de números brutos.
A partir daí, o trabalho é específico de cada plataforma, como de costume. No Zabbix, você importa a MIB, adiciona o SBC como host SNMP e cria items e triggers para os OIDs que lhe interessam. No PRTG, você adiciona sensores SNMP por métrica. No SolarWinds, você coloca o nó sob gerenciamento e seleciona os OIDs para criar gráficos. No Datadog, você configura sua integração SNMP com o perfil do dispositivo e credenciais. Em cada caso, o SBC faz a mesma coisa: responde polls na 161 e envia traps para a 162. As diferenças residem inteiramente em como cada NMS modela e visualiza o que coleta.
SNMP não é a única forma de observar o ProSBC, e para algumas integrações não é a mais adequada. A plataforma oferece três canais de monitoramento, e a escolha certa depende do que você está tentando fazer. Se você preferir não gerenciar a camada de coleta por conta própria, o Monitoring as a Service é uma opção gerenciada que fornece dashboards, alertas baseados em thresholds via e-mail, Slack, Teams ou Discord, análise histórica e suporte especializado sobre os mesmos dados subjacentes.
SNMP, REST API e CDRs: escolhendo o canal certo
O SNMP é a ferramenta certa para saúde do dispositivo em tempo real e alarmes de threshold, mas é um dos três meios pelos quais o ProSBC expõe dados operacionais, e um quadro completo de monitoramento geralmente utiliza mais de um. Escolher o canal errado para um trabalho tende a produzir lacunas ou complexidade desnecessária.
| Canal | Melhor para | Como funciona |
|---|---|---|
| SNMP | Saúde em tempo real, tendências de capacidade, alarmes orientados a eventos | O NMS faz polling no agente na 161 e recebe traps na 162 |
| REST API | Consultas de status e configuração a partir das suas próprias ferramentas | Seu sistema emite requisições HTTP GET para status e estado |
| Saída de CDR | Contabilização por chamada, reconciliação de billing, análise de qualidade de chamada | O SBC grava registros de detalhe de chamada em formato texto ou RADIUS |
O padrão que a maioria dos operadores adota é usar SNMP para a visão contínua de saúde e capacidade, a REST API para verificações de status automatizadas e automação dentro dos seus próprios sistemas, e CDRs para tudo que precisa ser reconstruído por chamada após o fato. Uma opção de linha de comando, o script tbstatus executado via SSH, também está disponível para verificações rápidas durante troubleshooting. O SNMP diz que a plataforma está saudável e quão carregada está; os CDRs dizem o que aconteceu em uma chamada específica quando você precisa investigar. Os dois respondem perguntas diferentes, e usar cada um para sua força é mais confiável do que esticar um para cobrir ambos.
O estado de alta disponibilidade é um bom exemplo de onde o SNMP ganha seu lugar. Uma implantação 1+1 é tão boa quanto sua consciência de qual nó está ativo e se um failover ocorreu, e um trap SNMP no evento de failover mais o estado HA consultado via polling forneça exatamente isso. O lado arquitetural de executar nós redundantes é coberto no guia de alta disponibilidade e failover.
Perguntas frequentes
Qual porta o SNMP usa?
O SNMP usa duas portas UDP. O agente no dispositivo monitorado escuta na UDP 161 para consultas de polling da estação de gerenciamento, e a estação de gerenciamento escuta na UDP 162 para traps e informs enviados pelos dispositivos. Ambas são padrões IANA; a porta de destino do trap é configurável no ProSBC se seu ambiente precisar de um valor não padrão.
Devo usar SNMPv2c ou SNMPv3 para um SBC?
Use SNMPv3 em um SBC. O SNMPv2c envia sua community string em texto puro, o que é aceitável apenas dentro de uma rede de gerenciamento rigorosamente controlada. O SNMPv3 adiciona autenticação por usuário e criptografia do payload através do User-based Security Model, que é a postura apropriada para um dispositivo exposto na borda da rede. O ProSBC suporta ambos, permitindo que você adapte a versão ao modelo de segurança da sua rede.
Posso monitorar o ProSBC com Zabbix, PRTG ou SolarWinds?
Sim. O ProSBC expõe um agente SNMP padrão, então qualquer plataforma com capacidade SNMP pode fazer polling nele, incluindo Zabbix, PRTG, SolarWinds, LibreNMS e Datadog através da sua integração SNMP. A configuração é a mesma de qualquer dispositivo: habilite o agente, configure uma community ou usuário SNMPv3, aponte um destino de trap para o seu NMS e carregue a MIB da TelcoBridges para que as métricas exibam com nomes.
Qual é a diferença entre um trap SNMP e um poll?
Um poll é o manager consultando o agente por um valor em um intervalo fixo, que é como você constrói gráficos de tendência e histórico de capacidade. Um trap é o agente enviando uma notificação ao manager no instante em que um evento ocorre, que é como você captura incidentes em tempo real. Você faz polling para tendências e configura traps para incidentes; uma configuração completa usa ambos.
Onde obtenho a MIB do ProSBC?
A MIB da TelcoBridges define os objetos enterprise-specific que o ProSBC reporta, e você a carrega no seu NMS para que os OIDs consultados e os traps recebidos apareçam como métricas nomeadas. Ela está disponível através do suporte e documentação da TelcoBridges, e obtê-la é o primeiro passo ao configurar o monitoramento SNMP, já que sem ela os OIDs enterprise retornam como números sem rótulo.
Qual é a diferença entre monitoramento SNMP, CDR e REST API?
O SNMP é para saúde do dispositivo em tempo real, tendências de capacidade e alarmes orientados a eventos. A REST API é para consultas de status e automação a partir das suas próprias ferramentas. Os CDRs são para contabilização por chamada, reconciliação de billing e análise de chamadas após o fato. O SNMP diz se a plataforma está saudável e quão carregada está; os CDRs dizem o que aconteceu em uma chamada individual. A maioria dos operadores usa os três para suas respectivas forças.
Monitore sua borda de voz com o ProSBC
SNMP é como um SBC ganha seu lugar no mesmo quadro operacional que o restante da sua rede. O ProSBC vem com um agente SNMP padrão com suporte a SNMPv1, SNMPv2c e SNMPv3 e destinos de trap configuráveis, integrando-se ao Zabbix, PRTG, SolarWinds ou qualquer plataforma com capacidade SNMP sem conector proprietário. Além do SNMP, a REST API e a saída de CDR completam um stack de monitoramento para saúde em tempo real, automação e contabilização por chamada.
Se você preferir que a camada de monitoramento seja executada para você, o Monitoring as a Service fornece dashboards, alertas de threshold e suporte especializado sobre os mesmos dados. E se você quiser cobertura operacional completa da própria plataforma, o Managed Service inclui HA 1+1, suporte 24/7 e monitoramento contínuo na infraestrutura de sua escolha.
Prefere avaliar por conta própria primeiro? Inicie seu teste grátis de 30 dias.