Códigos de resposta SIP 5xx: o que significam e como os SBCs lidam com eles
Quando uma chamada SIP falha, o código de resposta indica quem falhou e o que fazer, e a classe 5xx é a que decide se uma chamada terá uma segunda chance. Um 5xx significa que a requisição era perfeitamente válida, mas o servidor não conseguiu atendê-la, então a mesma chamada frequentemente terá sucesso contra um servidor diferente. Essa única propriedade é a razão pela qual os códigos 5xx acionam quase todo o comportamento de failover e avanço de rota em uma rede de voz em produção. Acerte o tratamento e um problema na operadora se torna um redirecionamento invisível; erre e ele se torna uma chamada perdida e um ticket de suporte.
A classe 5xx é a família de “erro de servidor” do SIP, definida na RFC 3261 junto com as outras cinco classes. Neste artigo, vamos guiar você por cada código 5xx em termos de produção, o que procurar em uma captura de pacotes, e como um Controlador de Borda de Sessão (SBC) transforma um erro de servidor em um failover limpo em vez de uma chamada falhada. Se você quer o dicionário completo cobrindo de 1xx a 6xx, o guia completo de códigos de resposta SIP é a referência para manter aberta ao lado deste. Esta página se aprofunda apenas nos 5xx.

O que 5xx significa e como difere de 4xx
Toda a classe 5xx se resume a uma decisão de roteamento: tente em outro lugar. Um 5xx diz que a requisição era sintaticamente válida, mas o respondente não conseguiu completá-la, o que fortemente implica que um servidor diferente poderia. Isso é o oposto da maioria dos códigos 4xx, onde a própria requisição estava errada e tentá-la novamente sem alterações contra outro servidor frequentemente falhará da mesma forma. Um 4xx geralmente significa pare; um 5xx geralmente significa avançar para a próxima rota.
A outra propriedade útil é que um 5xx geralmente é gerado hop by hop, por um intermediário ao longo do caminho (um proxy, um B2BUA, ou um switch de operadora) em vez de pelo endpoint chamado. Isso indica que a chamada nunca chegou ao destino final, e dá um ponto de partida para investigar qual elemento falhou. Para a taxonomia completa de todas as seis classes de resposta e como elas interagem, veja o guia completo; o restante desta página permanece dentro da família 5xx.
Os códigos 5xx, um por um
Para cada código abaixo: qual elemento tipicamente o emite, como aparece em uma captura, o que faz com a chamada upstream e a primeira coisa a verificar.
500 Server Internal Error
500 Server Internal Error é o código genérico de “algo quebrou do meu lado”. O respondente aceitou a requisição, mas encontrou uma falha que não consegue descrever com mais precisão, frequentemente um bug de software, uma consulta interna falhada ou um recurso esgotado em um switch de operadora ou servidor de aplicação. Em uma captura, chega como resposta final ao seu INVITE sem corpo útil, às vezes com um cabeçalho Warning contendo uma dica de uma linha. Um único 500 geralmente é transitório; 500s persistentes de uma operadora indicam uma falha de software no equipamento dessa operadora, não na sua configuração. Primeira verificação: é um peer ou todos? Um peer significa abrir um ticket com essa operadora e deixar o SBC fazer failover enquanto isso.
501 Not Implemented
501 Not Implemented significa que o servidor reconheceu o método SIP, mas não o suporta. O gatilho clássico é um REFER enviado a uma operadora que não oferece transferência de chamada, ou um INFO ou UPDATE que o lado remoto nunca implementou. A resposta deve carregar um cabeçalho Allow listando os métodos que o servidor suporta, que é a forma mais rápida de confirmar o que ele aceitará. Primeira verificação: leia o cabeçalho Allow, depois pare de enviar o método não suportado ou trate a função localmente no SBC em vez de encaminhá-la.
502 Bad Gateway
502 Bad Gateway diz que o respondente recebeu uma resposta inválida de um servidor mais adiante no caminho downstream. Em uma cadeia de SBCs e proxies, um 502 do próximo hop frequentemente significa que o problema se originou mais adiante. É um ponteiro, não um destino. Primeira verificação: capture no lado externo do próximo hop, se possível, porque a falha real está downstream de quem enviou o 502 para você.
503 Service Unavailable
503 Service Unavailable é o carro-chefe de toda a classe, e tem sua própria seção abaixo porque carrega mais nuances. Em resumo, significa que o servidor está saudável o suficiente para responder, mas não pode aceitar a requisição agora, porque está sobrecarregado, com rate limiting, atingindo um limite de sessões ou em manutenção. É o sinal que um SBC mais quer tratar, porque um 503 de um tronco é quase sempre uma razão limpa para fazer failover para outro. Primeira verificação: confirme que seu comportamento de avanço de rota realmente faz failover em 503, e procure um cabeçalho Retry-After.
504 Server Time-out
504 Server Time-out é o primo de sistema encadeado do 408 Request Timeout. A diferença é de quem o temporizador expirou. Um 408 significa que seu próprio temporizador de transação expirou esperando qualquer resposta. Um 504 significa que o servidor que respondeu a você estava ele próprio esperando por um servidor upstream que nunca respondeu a tempo. Então o 504 indica que o respondente está ativo e se comunicando, mas algo do qual depende não está. Primeira verificação: o servidor retornando o 504 está alcançável, então a falha está além dele; persiga a dependência que causou o timeout, não o peer que reportou o 504.
505 Version Not Supported
505 Version Not Supported significa que a versão SIP na linha de requisição não é suportada. Na prática, é uma peça de museu, porque SIP/2.0 é a única versão implantada há duas décadas. Se você alguma vez encontrar um, suspeite de uma linha de requisição malformada ou de uma ferramenta de teste enviando lixo, não de uma negociação real de versão.
513 Message Too Large
513 Message Too Large significa que a requisição excedeu o tamanho que o servidor aceitará no transporte atual. Este aparece no mundo real mais do que sua obscuridade sugere, quase sempre em UDP, quando um INVITE cresce além do limite do datagrama por causa de um corpo SDP grande, um conjunto extenso de cabeçalhos ou um cabeçalho Identity pesado carregando um PASSporT STIR/SHAKEN. A solução raramente é reduzir a mensagem; é mover esse peer para TCP ou TLS, onde mensagens grandes não são limitadas da mesma forma. Primeira verificação: esse peer está em UDP com INVITEs grandes? Mude o transporte.
580 Precondition Failure
580 Precondition Failure vem da RFC 3312 e significa que as precondições SDP na oferta não puderam ser atendidas, tipicamente uma reserva de recursos de Qualidade de Serviço (QoS) que a rede não conseguiu garantir antes de conectar a chamada. É raro, e você só o encontrará em interconexões que condicionam o estabelecimento de chamada à reserva de recursos. Primeira verificação: se as precondições são realmente necessárias neste segmento, porque muitas implantações as negociam quando não precisam.
503, Retry-After e controle de sobrecarga
O 503 merece tratamento próprio porque é o único código 5xx com comportamento de tratamento projetado. É a forma padrão de um servidor dizer “estou bem, mas estou cheio ou em manutenção, então volte depois ou vá para outro lugar”. Tratar todo 503 como uma falha definitiva desperdiça todo o propósito do código.
A peça-chave é o cabeçalho Retry-After, definido na RFC 3261 seção 20.33. Quando um servidor inclui Retry-After, está informando ao chamador quantos segundos esperar antes de tentar novamente aquele servidor específico. Um SBC bem comportado honra isso despriorizando temporariamente aquela rota pelo intervalo indicado, em vez de bombardear um servidor que explicitamente pediu um respiro. Ignorar o Retry-After e tentar novamente imediatamente tende a empurrar um servidor já sobrecarregado ainda mais para o limite.
Além do Retry-After por mensagem, o SIP define uma forma padronizada para um servidor ocupado pedir ao upstream para reduzir o tráfego antes de ter que começar a rejeitar tudo. A RFC 5390 estabelece os requisitos para controle de sobrecarga SIP, e a RFC 7339 define o mecanismo: parâmetros de controle de sobrecarga transportados no cabeçalho Via que permitem a um elemento downstream informar ao seu vizinho upstream para reduzir uma porcentagem do tráfego. Quando ambos os lados implementam, o congestionamento é gerenciado graciosamente e tempestades de 503 nunca começam. Muitos peers não implementam, porém, e simplesmente emitem 503 quando atingem seu limite, e é por isso que a reação do seu SBC a um 503 simples ainda importa.
As conclusões práticas são simples. Um 503 de um primário saudável deve fazer failover de forma limpa para uma rota de backup. Uma onda repentina de 503s é um sinal de capacidade ou indisponibilidade no nível do tronco, não um defeito por chamada, e deve ser lida como “essa operadora está com problemas” em vez de “essa chamada estava ruim”.
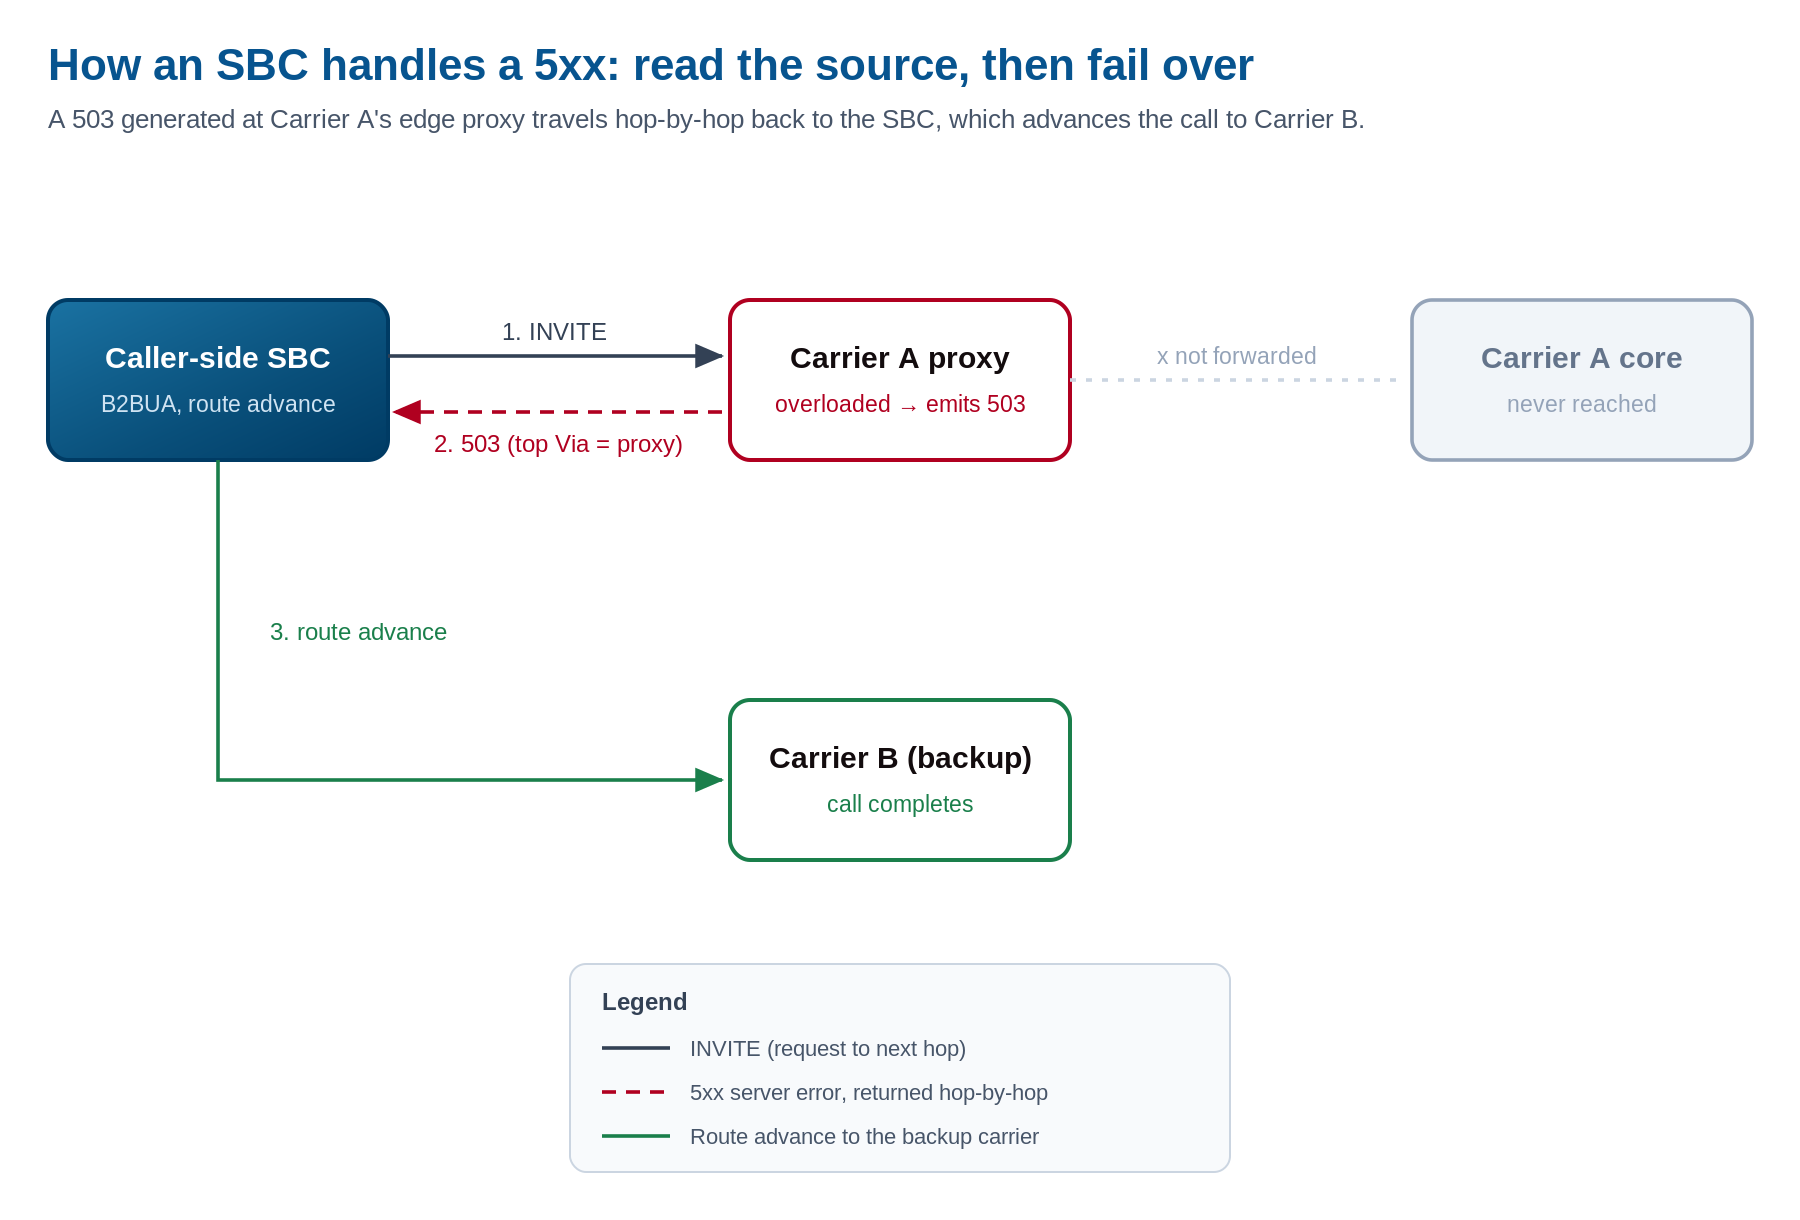
Um 503 é gerado no proxy de borda da Operadora A e viaja hop-by-hop de volta ao SBC, não do core da operadora atrás dele. O SBC lê o Via mais ao topo para ver qual elemento falhou, e então avança a chamada para uma operadora de backup. Clique para ampliar.
Como um 5xx aparece em uma captura de pacotes
Ler um 5xx em um trace é principalmente responder uma pergunta: qual elemento o enviou? A pilha de cabeçalhos Via é onde você descobre. A entrada Via mais ao topo associada ao processamento da resposta identifica o hop que a gerou, então um 503 cujo Via mais ao topo é o proxy de borda da operadora foi emitido ali, não pelo switch de destino atrás dele. Isso imediatamente indica quão longe a chamada realmente chegou.
A natureza hop-by-hop da maioria dos códigos 5xx é por si só uma pista. Como um intermediário gerou a resposta, ela não carregará o contexto fim-a-fim que você veria da parte chamada, o que confirma que a chamada nunca chegou ao destino final. Procure também por um cabeçalho Warning, definido na RFC 3261, que frequentemente carrega uma explicação curta e legível, e um cabeçalho Reason da RFC 3326, que pode carregar um valor de causa Q.850 quando a falha está sendo convertida de uma rede TDM. Esses dois cabeçalhos são onde o “porquê” geralmente se esconde.
Mais um comportamento que vale conhecer para leitura de traces: o ACK para respostas finais não-2xx é gerado dentro da transação INVITE e segue o caminho de sinalização existente, diferentemente do ACK fim-a-fim que um 200 OK exige. Se você ver um 5xx sem ACK correspondente, a transação não fechou corretamente, e isso é um problema próprio para investigar. Para o método geral de leitura de qualquer trace SIP, um walkthrough dedicado de traces cobre pontos de captura e ferramentas, e o artigo sobre fluxo de chamada SIP mostra onde esses códigos aparecem em uma chamada completa; esta seção é apenas a parte específica de 5xx.
Como um SBC lida com 5xx
A razão pela qual um SBC fica na borda de uma rede multi-operadora é precisamente para que o erro de um único servidor não se torne a chamada perdida do seu cliente. Um SBC B2BUA encerra o segmento de entrada e origina um segmento de saída independente, o que significa que ele vê o 5xx de um lado e decide, em seus próprios termos, o que o outro lado deve ouvir. O mesmo controle que permite manipulação de cabeçalhos SIP e sinalização SIP em cada segmento permite reescrever um código de resposta ou mudar qual decisão de roteamento ele aciona.
O comportamento central é o avanço de rota. O SBC mapeia um 5xx como “avançar para a próxima rota” para que um erro de servidor em uma operadora faça failover da chamada para um caminho de backup, enquanto um 4xx geralmente é deixado para parar a chamada, porque tentar novamente uma requisição rejeitada em outro lugar raramente ajuda. Honrar o Retry-After é a próxima camada: quando um 503 o inclui, o SBC marca aquela rota como indisponível pelo intervalo indicado em vez de tentar contra uma parede. 503s repetidos do mesmo peer podem removê-lo da rotação completamente até que keepalives OPTIONS mostrem que se recuperou, então uma operadora degradada para de atrair tráfego automaticamente.
Redes reais são complexas o suficiente para que essas decisões precisem ser configuradas por grupo de troncos em vez de globalmente, porque o 503 de uma operadora pode significar congestionamento genuíno enquanto o de outra sinaliza uma indisponibilidade que você quer escalar imediatamente. O ProSBC lida com isso com controle por segmento em até 1.024 Pontos de Acesso de Rede (grupos de troncos), para que o comportamento de avanço de rota e código de causa para cada peer possa corresponder ao que aquele peer realmente faz. Com mais de vinte anos de implantação SIP de operadora por trás e capacidade para até 60.000 sessões por servidor, esse controle por peer é o que mantém o tratamento de 5xx coerente quando dezenas de operadoras se comportam de forma diferente em escala.
A última peça é visibilidade. Uma taxa crescente de 5xx em um tronco é o sinal mais precoce legível por máquina de uma indisponibilidade do lado da operadora, geralmente visível no seu monitoramento antes que um único cliente perceba. Exibir contagens de 5xx por rota em um dashboard, com limites de alerta, transforma os mesmos códigos que acionam failover automático em um sistema de alerta antecipado para os humanos de plantão.
Perguntas frequentes
Um 503 é uma falha de chamada?
Na verdade, não. Um 503 é um sinal de “tente em outro lugar”, e se seu SBC fizer failover corretamente, a chamada ainda será completada. Filtre eventos de 503-com-failover das suas métricas brutas de falha e reporte-os como failovers bem-sucedidos, ou seus dashboards vão superestimar quantas chamadas realmente falharam.
Devo tentar novamente um 5xx contra o mesmo servidor?
Somente após o intervalo em um cabeçalho Retry-After, ou com backoff sensível. Uma nova tentativa imediata contra o mesmo servidor geralmente produz o mesmo 5xx, e durante uma sobrecarga, piora a situação.
Qual é a diferença entre 408 e 504?
De quem o temporizador expirou. Um 408 Request Timeout significa que seu próprio temporizador de transação expirou esperando qualquer resposta. Um 504 Server Time-out significa que o servidor respondeu a você, mas estava esperando por um servidor upstream que nunca respondeu. Com um 504, o peer com quem você está falando está ativo; a dependência atrás dele não está.
Por que estou recebendo um 503 de uma operadora que claramente está ativa?
Quase sempre capacidade, não saúde. Limites de sessão, rate limiting e controle de sobrecarga se manifestam como 503 de um switch perfeitamente saudável. Significa “cheio”, não “quebrado”.
Por que INVITEs grandes retornam com um 513?
A mensagem excedeu o limite de tamanho do transporte, que é uma restrição de datagrama UDP na grande maioria dos casos. Mova esse peer para TCP ou TLS e o INVITE superdimensionado, frequentemente inflado por um SDP grande ou um cabeçalho Identity STIR/SHAKEN, passará sem problemas.
Conclusão
A classe 5xx é pequena, mas de alto valor: erros do lado do servidor que geralmente podem ser tentados em outro lugar, e o motor por trás de quase todo failover limpo em uma rede de voz. Saber qual elemento emitiu o código, se um Retry-After está anexado e se a causa é saúde ou capacidade é o que transforma um erro de servidor em uma chamada redirecionada em vez de uma chamada perdida. Mantenha o guia completo de códigos de resposta acessível para as outras cinco classes, e trate o 5xx como seu kit de ferramentas de avanço de rota.
Transforme cada erro de servidor em um failover limpo com o ProSBC
Como um B2BUA completo, o ProSBC encerra e re-origina cada segmento de chamada, para que possa transformar qualquer 5xx de um peer na decisão de roteamento que sua rede realmente precisa: avançar para uma operadora de backup, honrar um intervalo Retry-After, manter um peer sobrecarregado fora de rotação até que se recupere, e alimentar a taxa de 5xx diretamente no monitoramento.
Seu motor de roteamento baseado em regras e orientado a API suporta failover multi-rota baseado em prioridade, e o controle por NAP em até 1.024 grupos de troncos significa que o uso idiossincrático de 503, 500 e demais códigos por cada operadora pode ser tratado em seus próprios termos, em vez de com uma única regra global.
Prefere avaliar por conta própria primeiro? Inicie seu teste gratuito de 30 dias.