SNMP pour la surveillance des SBC et de la VoIP : ports, MIB et pratiques opérationnelles
Comment SNMP fonctionne réellement sur une infrastructure voix : quels ports transportent quoi, comment lire la MIB du SBC, quand interroger ou écouter les traps, et comment intégrer le tout à la plateforme de supervision que vous utilisez déjà.
SNMP (Simple Network Management Protocol) est le langage commun des plateformes de gestion réseau, et un session border controller situé à la périphérie voix est un appareil de plus sur le réseau qui devrait remonter dans les mêmes tableaux de bord que vos routeurs, commutateurs et serveurs. Le protocole est généraliste, mais la façon dont on l’applique à une plateforme voix a ses particularités : les compteurs importants sont les compteurs d’appels et d’enregistrements, les alarmes qui vous réveillent sont les basculements HA et les attaques au niveau SIP, et les enjeux de sécurité sont plus élevés parce que l’appareil se trouve au périmètre du réseau.
Si vous êtes un ingénieur responsable du bon fonctionnement d’une infrastructure voix, cet article vous guide à travers SNMP sous l’angle opérationnel : les ports utilisés et pourquoi, la différence entre l’interrogation et les traps, les trois versions de SNMP et laquelle convient à un équipement en périphérie, comment lire ce que le SBC expose via sa MIB, et comment connecter ProSBC à Zabbix, PRTG, SolarWinds ou toute autre plateforme compatible SNMP. Pour la question plus large des métriques voix à suivre et de la définition des seuils, le guide des meilleures pratiques de supervision VoIP couvre le volet stratégique ; cette page se concentre sur SNMP en tant que tel.

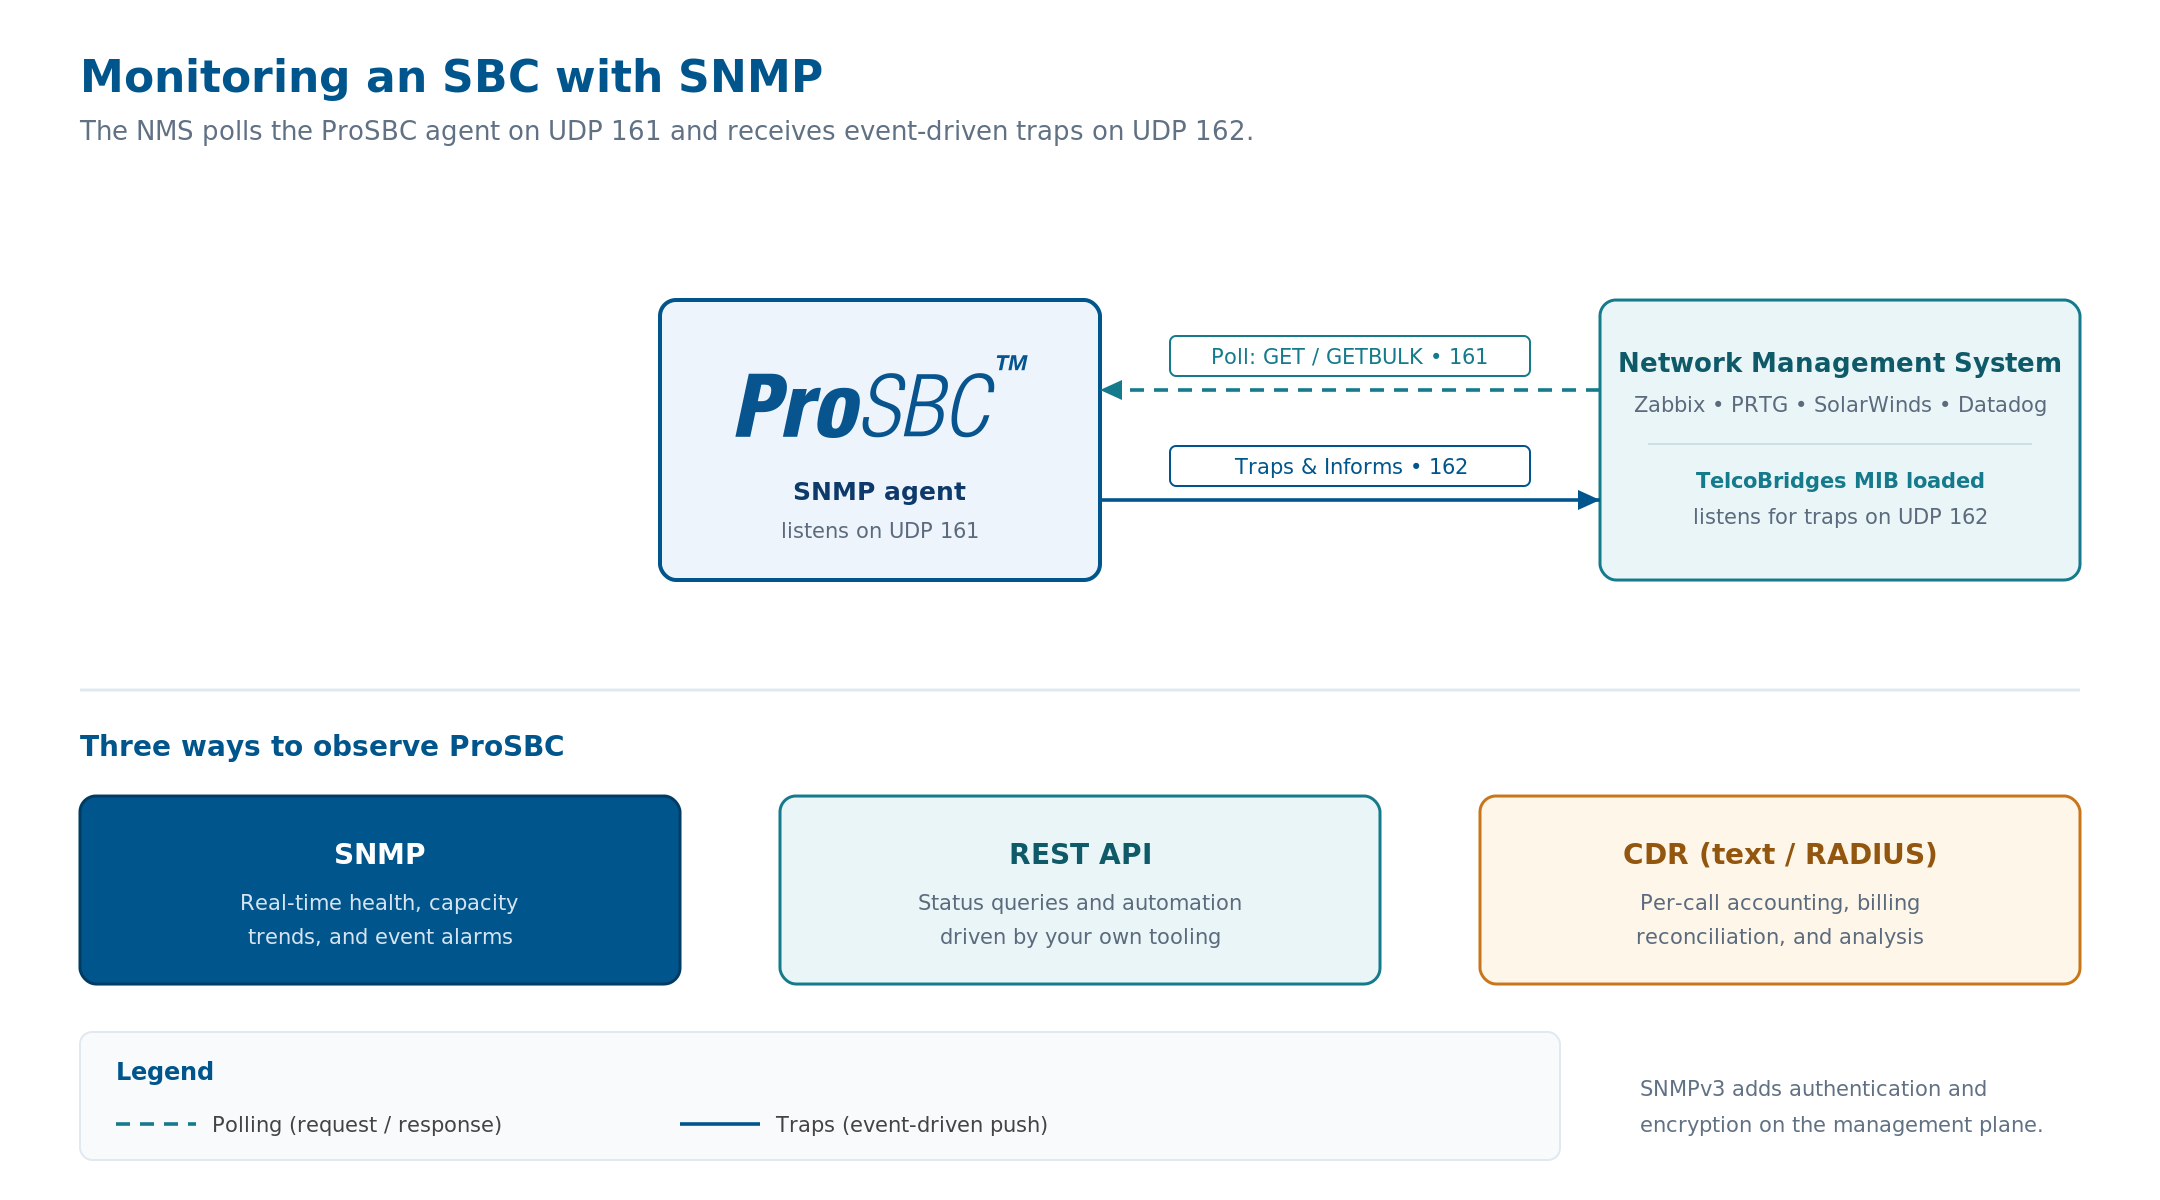
Topologie de surveillance SNMP pour un SBC : le NMS interroge l’agent ProSBC sur UDP 161 et reçoit les traps événementiels sur UDP 162. La MIB TelcoBridges, chargée dans le NMS, traduit les OID de l’agent en métriques nommées. La REST API et la sortie CDR fonctionnent comme des canaux séparés pour les requêtes d’état et la comptabilité par appel. Cliquez pour agrandir.
Ports SNMP : 161 et 162 expliqués
SNMP utilise deux ports UDP bien connus, et les distinguer constitue la base de tout ce qui suit. Le port 161 est celui sur lequel l’agent de l’appareil écoute les requêtes entrantes de la station de gestion. Lorsque votre NMS veut connaître le nombre de sessions actives ou le temps de fonctionnement du SBC, il envoie une requête sur UDP 161 du SBC et lit la réponse. Le port 162 fonctionne dans la direction opposée : c’est celui sur lequel la station de gestion écoute les traps et les informs que les appareils lui envoient. Lorsque le SBC doit signaler qu’un basculement vient de se produire, il envoie cette notification sur UDP 162 du manager.
SNMP utilise normalement UDP (ports 161 et 162), bien que le transport TCP soit défini pour certaines implémentations et déploiements spécialisés. Le trafic de supervision doit rester léger et ne doit pas ajouter de charge ou de latence à un appareil déjà occupé à acheminer des appels. SNMP accepte donc le faible risque d’un paquet perdu en échange d’une surcharge minimale. Une interrogation manquée est simplement retentée à l’intervalle suivant, et les conséquences d’un trap manqué sont gérées en utilisant des informs lorsque la garantie de livraison est importante.
Les valeurs 161 et 162 sont les valeurs par défaut enregistrées auprès de l’IANA, et la quasi-totalité des déploiements les conservent telles quelles afin que la découverte automatique du NMS fonctionne sans configuration particulière. Elles ne sont pas immuables pour autant. Sur ProSBC, la destination des traps, y compris son port, est un champ configurable, vous pouvez donc diriger les notifications vers un manager écoutant sur un port autre que le 162 standard si votre environnement l’exige. La conclusion pratique pour la planification des pare-feux est que vous ouvrez UDP 161 en entrée vers le SBC depuis votre réseau de gestion pour l’interrogation, et UDP 162 en entrée vers votre NMS depuis le SBC pour les traps. Comme le SBC se trouve en périphérie, ces règles doivent limiter la source au sous-réseau de gestion plutôt que de laisser les ports ouverts au monde entier.
Interrogation versus traps : deux directions de supervision
SNMP déplace les données dans deux directions, et une configuration de supervision saine utilise les deux. Comprendre quand chacune s’applique est ce qui distingue un système d’alertes bruyant d’un système auquel votre équipe fait réellement confiance.
L’interrogation (polling) consiste pour le manager à demander une valeur à l’agent selon un calendrier, par exemple toutes les 60 secondes. C’est ainsi que vous construisez les graphiques montrant l’évolution du nombre de sessions, du CPU, de la mémoire et du total des enregistrements dans le temps. L’interrogation fournit la ligne de base continue qui rend la planification de capacité possible et permet de repérer une dérive lente avant qu’elle ne devienne une panne. Sa limitation est la résolution : tout ce qui se produit et se résout à l’intérieur de l’intervalle d’interrogation peut être entièrement manqué, et resserrer l’intervalle pour capturer les événements rapides multiplie la charge de requêtes sur chaque appareil supervisé.
Les traps inversent ce modèle en faisant pousser par l’agent une notification à l’instant où un événement se déclenche, de sorte qu’un basculement ou un dépassement de seuil atteigne votre NMS en temps réel plutôt que d’attendre la prochaine interrogation. C’est ce que vous souhaitez pour tout ce qui est sensible au temps sur une plateforme voix. Le compromis est qu’un trap standard fonctionne en mode fire-and-forget sur UDP : si le paquet est perdu, l’événement est simplement disparu. Les informs résolvent ce problème en exigeant que le manager accuse réception, ce qui vaut le coût de l’aller-retour supplémentaire pour les alarmes que vous ne pouvez pas vous permettre de manquer.
En pratique, vous interrogez pour les tendances et vous trappez pour les incidents. Interrogez les compteurs du SBC pour alimenter les tableaux de bord et les rapports de capacité, et configurez des traps pour les événements qui exigent une réponse humaine immédiate. S’appuyer uniquement sur l’interrogation laisse un angle mort pendant les secondes entre les intervalles, et s’appuyer uniquement sur les traps ne fournit aucune ligne de base pour les interpréter.
Versions SNMP : v1, v2c et v3
Trois versions de SNMP sont en usage actif, et la différence entre elles porte principalement sur la sécurité, ce qui compte beaucoup pour un appareil exposé en périphérie de réseau.
SNMPv1 n’est plus recommandé pour les nouveaux déploiements. Il s’authentifie avec une chaîne de communauté et n’offre aucun chiffrement, et sa gestion d’erreurs limitée et ses compteurs de taille réduite en font un choix inadapté aux volumes de trafic opérateur modernes.
SNMPv2c reste largement déployé parce qu’il conserve le modèle simple de la chaîne de communauté tout en ajoutant des compteurs 64 bits, l’opération GETBULK plus efficace et le type de notification inform. Le bémol est le même que pour la v1 : la chaîne de communauté traverse le réseau en clair, de sorte que quiconque peut capturer un paquet peut la lire et la réutiliser. C’est acceptable à l’intérieur d’un VLAN de gestion verrouillé, et c’est réellement risqué partout où une chaîne de communauté pourrait être interceptée.
SNMPv3 est la version qui a sa place sur un session border controller. Elle remplace la chaîne de communauté par le modèle de sécurité basé sur l’utilisateur (User-based Security Model), qui fournit une authentification par utilisateur (HMAC avec SHA) et un chiffrement optionnel de la charge utile (AES). Exécuter la v3 en mode authPriv signifie que les identifiants et les données de supervision elles-mêmes sont protégés sur le réseau, ce qui est exactement la posture souhaitée pour un appareil situé en périphérie et rapportant sur le trafic d’appels en direct. ProSBC prend en charge les deux modèles : vous pouvez créer une communauté SNMPv1 ou SNMPv2c lorsqu’un réseau interne durci le permet, ou créer un utilisateur SNMPv3 lorsque l’authentification et le chiffrement sont requis. La même réflexion de sécurité en périphérie qui régit la sécurité du SBC dans son ensemble s’applique au plan de gestion, et SNMPv3 est le moyen de l’y étendre.
Ce que le SBC expose : lire la MIB
Chaque valeur qu’un agent SNMP peut rapporter possède un OID, une adresse en notation pointée comme 1.3.6.1.2.1.1.3.0 pour le temps de fonctionnement du système. Les OID sont organisés en arbre, avec des branches standard que chaque appareil partage (les groupes système et interface de MIB-2, par exemple) et une branche d’entreprise privée sous 1.3.6.1.4.1 où chaque fabricant définit ses propres objets. Une MIB est le fichier qui traduit ces nombres en noms, afin que votre NMS puisse afficher « temps de fonctionnement du système » au lieu d’une chaîne de chiffres.
Pour superviser correctement un SBC, vous chargez deux types de MIB dans votre NMS. Les MIB standard vous donnent les objets universels de santé de l’appareil : temps de fonctionnement, CPU, mémoire, état et débit des interfaces réseau, et autres données système similaires que vous collecteriez sur n’importe quel serveur. La MIB d’entreprise du fabricant vous donne les objets spécifiques à la plateforme. Pour ProSBC, la MIB TelcoBridges est ce dont votre NMS a besoin pour nommer et représenter graphiquement les objets spécifiques au SBC, et c’est la première chose à obtenir lorsque vous configurez la supervision, car sans elle les OID d’entreprise reviennent sous forme de nombres bruts que votre plateforme ne peut pas étiqueter.
Les objets à surveiller sur une plateforme voix se répartissent en quelques groupes : santé du système (CPU, mémoire, disque, temps de fonctionnement), l’état de haute disponibilité du nœud, le nombre de sessions et d’appels actifs par rapport à votre capacité sous licence, et le total des enregistrements de terminaux. Ce sont les valeurs qui vous indiquent si la plateforme est en bonne santé et à quel point elle s’approche de ses limites. Les métriques de qualité d’appel plus approfondies qui intéressent les équipes VoIP, comme le taux de réponse aux prises (ASR), le délai post-numérotation et le Mean Opinion Score, font partie d’un tableau de supervision plus large combinant SNMP avec l’analyse des CDR et les statistiques média. Le guide des meilleures pratiques de supervision VoIP couvre les métriques à prioriser et comment définir les seuils correspondants.
Associer les traps SNMP aux incidents opérationnels
Un trap n’est utile que s’il correspond clairement à une action. L’objectif lors de la conception de vos alertes est que chaque trap qui alerte un humain corresponde à quelque chose qu’un humain doit réellement faire, car un SBC qui inonde le NMS de notifications à faible valeur entraîne votre équipe à ignorer le canal qui devrait compter le plus. Le tableau ci-dessous montre le type d’association qui fonctionne bien pour une plateforme voix.
| Signal SNMP | Ce que cela signifie généralement | Réponse opérationnelle |
|---|---|---|
| Trap de basculement HA | Le nœud de secours a pris le relais du nœud actif | Alerter l’astreinte immédiatement ; investiguer le nœud défaillant avant que la paire ne soit exposée à une seconde panne |
| Nombre de sessions approchant la capacité sous licence | Le trafic approche le plafond du déploiement | Planifier la capacité maintenant ; un plafond strict rejette les nouveaux appels au lieu de se dégrader progressivement |
| Pic ou effondrement du nombre d’enregistrements | Un flood d’enregistrements, ou une panne en amont déconnectant les terminaux | Corréler avec les journaux de sécurité ; un flood est une possible attaque SIP, un effondrement pointe en amont |
| Interface down ou changement d’état de lien | Un chemin réseau physique ou virtuel est tombé | Vérifier le chemin avant que le média ne soit affecté ; l’audio unidirectionnel commence souvent ici |
| Seuil de ressources (CPU, mémoire, disque) | L’hôte est sous pression et peut se dégrader | Investiguer la cause ; une pression soutenue précède les problèmes de qualité |
Le principe derrière cette association est que les traps déclenchent des incidents tandis que l’interrogation alimente les tendances. Vous configurez le SBC pour trapper sur les changements d’état nécessitant une réponse rapide, et vous vous appuyez sur l’historique interrogé pour comprendre ce qui se passait dans les minutes précédant le déclenchement du trap. Lorsqu’un trap de basculement arrive, les graphiques interrogés de CPU, de sessions et de débit d’interface y menant sont ce qui transforme une alarme brute en diagnostic.
Intégrer le SNMP de ProSBC à votre plateforme de supervision
Parce que ProSBC expose un agent SNMP standard, l’intégration suit le même schéma que pour tout autre appareil sur votre réseau. Toute plateforme compatible SNMP peut l’interroger, y compris Zabbix, PRTG, SolarWinds et LibreNMS, ainsi que Datadog via son intégration SNMP. Il n’y a pas de connecteur propriétaire à installer de part et d’autre, ce qui est tout l’intérêt d’utiliser un protocole standard.
La configuration se fait en quatre étapes côté ProSBC. Premièrement, activez l’agent SNMP dans les paramètres système du portail web. Deuxièmement, créez les identifiants que le manager utilisera, soit une communauté SNMPv1 ou SNMPv2c pour un réseau interne durci, soit de préférence un utilisateur SNMPv3 avec authentification et chiffrement. Troisièmement, créez une destination de trap pointant vers votre NMS pour que les notifications d’événements aient un destinataire. Quatrièmement, chargez la MIB TelcoBridges dans votre NMS pour que les OID interrogés et les traps entrants s’affichent sous forme de métriques nommées et représentables graphiquement plutôt que de nombres bruts.
À partir de là, le travail est spécifique à chaque plateforme comme d’habitude. Dans Zabbix, vous importez la MIB, ajoutez le SBC comme hôte SNMP et créez des items et des déclencheurs sur les OID qui vous intéressent. Dans PRTG, vous ajoutez des capteurs SNMP par métrique. Dans SolarWinds, vous placez le nœud sous gestion et sélectionnez les OID à représenter graphiquement. Dans Datadog, vous configurez son intégration SNMP avec le profil et les identifiants de l’appareil. Dans chaque cas, le SBC fait la même chose : répondre aux interrogations sur le port 161 et envoyer les traps sur le port 162. Les différences résident entièrement dans la façon dont chaque NMS modélise et visualise ce qu’il collecte.
SNMP n’est pas le seul moyen d’observer ProSBC, et pour certaines intégrations ce n’est pas le mieux adapté. La plateforme offre trois canaux de supervision, et le bon choix dépend de ce que vous essayez de faire. Si vous préférez ne pas gérer vous-même la couche de collecte, la supervision en tant que service (Monitoring as a Service) est une option gérée qui fournit des tableaux de bord, des alertes basées sur des seuils par e-mail, Slack, Teams ou Discord, une analyse historique et un support expert sur les mêmes données sous-jacentes.
SNMP, REST API et CDR : choisir le bon canal
SNMP est le bon outil pour la santé de l’appareil en temps réel et les alarmes de seuil, mais c’est l’un des trois moyens par lesquels ProSBC expose les données opérationnelles, et un tableau de supervision complet s’appuie généralement sur plus d’un canal. Choisir le mauvais canal pour une tâche tend à produire soit des lacunes, soit une complexité inutile.
| Canal | Idéal pour | Fonctionnement |
|---|---|---|
| SNMP | Santé en temps réel, tendances de capacité, alarmes événementielles | Le NMS interroge l’agent sur le port 161 et reçoit les traps sur le port 162 |
| REST API | Requêtes d’état et configuration depuis vos propres outils | Votre système émet des requêtes HTTP GET pour l’état et la situation |
| Sortie CDR | Comptabilité par appel, réconciliation de facturation, analyse de la qualité d’appel | Le SBC écrit des enregistrements détaillés d’appels au format texte ou RADIUS |
Le schéma sur lequel la plupart des opérateurs convergent consiste à utiliser SNMP pour la vue permanente de santé et de capacité, la REST API pour les vérifications d’état scriptées et l’automatisation intégrée à leurs propres systèmes, et les CDR pour tout ce qui doit être reconstitué par appel après coup. Une option en ligne de commande, le script tbstatus exécuté via SSH, est également disponible pour des vérifications ponctuelles rapides lors du dépannage. SNMP vous dit que la plateforme est en bonne santé et à quel point elle est chargée ; les CDR vous disent ce qui s’est passé sur un appel spécifique lorsque vous devez investiguer. Les deux répondent à des questions différentes, et utiliser chacun pour sa force est plus fiable que d’en étirer un pour couvrir les deux.
L’état de haute disponibilité est un bon exemple de la valeur ajoutée de SNMP. Un déploiement 1+1 n’est aussi bon que votre connaissance du nœud actif et de l’occurrence d’un basculement, et un trap SNMP sur l’événement de basculement combiné à l’état HA interrogé vous donne exactement cela. Le volet architectural de l’exploitation de nœuds redondants est couvert dans le guide de haute disponibilité et de basculement.
Questions fréquemment posées
Quel port utilise SNMP ?
SNMP utilise deux ports UDP. L’agent sur l’appareil supervisé écoute sur UDP 161 les requêtes d’interrogation de la station de gestion, et la station de gestion écoute sur UDP 162 les traps et informs envoyés par les appareils. Les deux sont les valeurs par défaut de l’IANA ; le port de destination des traps est configurable sur ProSBC si votre environnement nécessite une valeur non standard.
Dois-je utiliser SNMPv2c ou SNMPv3 pour un SBC ?
Utilisez SNMPv3 sur un session border controller. SNMPv2c envoie sa chaîne de communauté en clair, ce qui n’est acceptable qu’à l’intérieur d’un réseau de gestion étroitement contrôlé. SNMPv3 ajoute une authentification par utilisateur et un chiffrement de la charge utile via le modèle de sécurité basé sur l’utilisateur (User-based Security Model), ce qui est la posture appropriée pour un appareil exposé en périphérie de réseau. ProSBC prend en charge les deux, vous pouvez donc adapter la version au modèle de sécurité de votre réseau.
Puis-je superviser ProSBC avec Zabbix, PRTG ou SolarWinds ?
Oui. ProSBC expose un agent SNMP standard, donc toute plateforme compatible SNMP peut l’interroger, y compris Zabbix, PRTG, SolarWinds, LibreNMS et Datadog via son intégration SNMP. La configuration est la même que pour tout appareil : activez l’agent, configurez une communauté ou un utilisateur SNMPv3, pointez une destination de trap vers votre NMS et chargez la MIB TelcoBridges pour que les métriques s’affichent avec des noms.
Quelle est la différence entre un trap SNMP et une interrogation ?
Une interrogation (poll) consiste pour le manager à demander une valeur à l’agent selon un calendrier fixe, ce qui permet de construire des graphiques de tendances et un historique de capacité. Un trap est l’agent qui envoie une notification au manager à l’instant où un événement se produit, ce qui permet de détecter les incidents en temps réel. Vous interrogez pour les tendances et vous trappez pour les incidents ; une configuration complète utilise les deux.
Où puis-je obtenir la MIB de ProSBC ?
La MIB TelcoBridges définit les objets spécifiques à l’entreprise que ProSBC rapporte, et vous la chargez dans votre NMS pour que les OID interrogés et les traps entrants apparaissent comme des métriques nommées. Elle est disponible auprès du support et de la documentation TelcoBridges, et l’obtenir est la première étape lorsque vous configurez la supervision SNMP, car sans elle les OID d’entreprise reviennent sous forme de nombres non étiquetés.
En quoi la supervision SNMP diffère-t-elle de la supervision par CDR ou REST API ?
SNMP est destiné à la santé de l’appareil en temps réel, aux tendances de capacité et aux alarmes événementielles. La REST API sert aux requêtes d’état et à l’automatisation pilotée par vos propres outils. Les CDR servent à la comptabilité par appel, à la réconciliation de facturation et à l’analyse d’appels après coup. SNMP vous dit que la plateforme est en bonne santé et à quel point elle est chargée ; les CDR vous disent ce qui s’est passé sur un appel individuel. La plupart des opérateurs utilisent les trois pour leurs forces respectives.
Supervisez votre périphérie voix avec ProSBC
SNMP est la façon dont un session border controller gagne sa place dans le même tableau opérationnel que le reste de votre réseau. ProSBC embarque un agent SNMP standard avec la prise en charge de SNMPv1, SNMPv2c et SNMPv3 et des destinations de trap configurables, de sorte qu’il s’intègre à Zabbix, PRTG, SolarWinds ou toute plateforme compatible SNMP sans connecteur propriétaire. En complément de SNMP, la REST API et la sortie CDR complètent une pile de supervision intégrale pour la santé en temps réel, l’automatisation et la comptabilité par appel.
Si vous préférez que la couche de supervision soit gérée pour vous, la supervision en tant que service (Monitoring as a Service) fournit des tableaux de bord, des alertes de seuil et un support expert sur les mêmes données. Et si vous souhaitez une couverture opérationnelle complète de la plateforme elle-même, le service géré (Managed Service) inclut la HA 1+1, le support 24/7 et la supervision continue sur l’infrastructure de votre choix.
Vous préférez évaluer par vous-même d’abord ? Commencez votre essai gratuit de 30 jours.