Codes de réponse SIP 5xx : signification et traitement par les SBC
Lorsqu’un appel SIP échoue, le code de réponse indique quel élément a échoué et ce qu’il faut faire, et la classe 5xx est celle qui décide si l’appel obtient une seconde chance. Un code 5xx signifie que la requête était parfaitement valide mais que le serveur n’a pas pu la traiter ; le même appel aboutira donc souvent auprès d’un autre serveur. Cette propriété fondamentale explique pourquoi les codes 5xx pilotent la quasi-totalité du basculement et de l’avancement de route dans un réseau vocal en production. Si le traitement est correct, un incident opérateur se transforme en un reroutage invisible ; s’il est incorrect, il se transforme en un appel perdu et un ticket de support.
La classe 5xx est la famille « erreur serveur » de SIP, définie dans la RFC 3261 aux côtés des cinq autres classes. Dans cet article, nous détaillons chaque code 5xx en termes opérationnels : ce qu’il faut rechercher dans une capture de paquets et comment un Session Border Controller (SBC) transforme une erreur serveur en basculement propre plutôt qu’en appel échoué. Si vous souhaitez le dictionnaire complet couvrant les classes 1xx à 6xx, le guide complet des codes de réponse SIP est la référence à garder ouverte en parallèle. Cette page approfondit uniquement les codes 5xx.

Ce que signifie 5xx, et en quoi il diffère de 4xx
Toute la classe 5xx se résume à une seule décision de routage : essayer ailleurs. Un 5xx indique que la requête était syntaxiquement valide mais que le répondeur n’a pas pu la traiter, ce qui implique fortement qu’un autre serveur pourrait y parvenir. C’est l’opposé de la plupart des codes 4xx, où la requête elle-même était erronée et la réessayer telle quelle auprès d’un autre serveur échouera souvent de la même manière. Un 4xx signifie généralement « arrêtez » ; un 5xx signifie généralement « avancez vers la route suivante ».
L’autre propriété utile est qu’un 5xx est généralement généré saut par saut, par un intermédiaire le long du chemin (un proxy, un B2BUA ou un commutateur opérateur) plutôt que par le terminal appelé. Cela vous indique que l’appel n’a jamais atteint l’extrémité distante, et cela vous donne un point de départ pour identifier quel élément investiguer. Pour la taxonomie complète des six classes de réponse et leurs interactions, consultez le guide complet ; le reste de cette page se concentre sur la famille 5xx.
Les codes 5xx, un par un
Pour chaque code ci-dessous : quel élément l’émet typiquement, comment il apparaît dans une capture, ce qu’il provoque en amont, et la première chose à vérifier.
500 Erreur interne du serveur
500 Erreur interne du serveur est le code générique « quelque chose a cassé de mon côté ». Le répondeur a accepté la requête, puis a rencontré un défaut qu’il ne peut pas décrire plus précisément, souvent un bug logiciel, une recherche interne échouée ou une ressource épuisée sur un commutateur opérateur ou un serveur d’application. Dans une capture, il arrive comme réponse finale à votre INVITE sans corps utile, parfois avec un en-tête Warning contenant un indice sur une ligne. Un 500 isolé est généralement transitoire ; des 500 persistants provenant d’un même opérateur indiquent un défaut logiciel sur l’équipement de cet opérateur, pas un problème de configuration de votre côté. Première vérification : est-ce un seul pair ou tous ? Un seul pair signifie ouvrir un ticket auprès de cet opérateur et laisser le SBC basculer en attendant.
501 Non implémenté
501 Non implémenté signifie que le serveur a reconnu la méthode SIP mais ne la prend pas en charge. Le déclencheur classique est un REFER envoyé à un opérateur qui n’offre pas le transfert d’appel, ou un INFO ou UPDATE que l’autre côté n’a jamais implémenté. La réponse devrait contenir un en-tête Allow listant les méthodes prises en charge par le serveur, ce qui est le moyen le plus rapide de confirmer ce qu’il accepte. Première vérification : lisez l’en-tête Allow, puis cessez d’envoyer la méthode non prise en charge ou traitez la fonction localement sur le SBC au lieu de la relayer.
502 Mauvaise passerelle
502 Mauvaise passerelle signifie que le répondeur a reçu une réponse invalide d’un serveur situé plus en aval. Dans une chaîne de SBC et de proxys, un 502 provenant du prochain saut signifie souvent que le problème est apparu plus loin en aval. C’est un indicateur, pas une destination. Première vérification : capturez du côté distant du prochain saut si possible, car le véritable défaut se situe en aval de celui qui vous a envoyé le 502.
503 Service indisponible
503 Service indisponible est le code principal de toute la classe, et il dispose de sa propre section ci-dessous en raison de ses nombreuses subtilités. En résumé, il signifie que le serveur est suffisamment fonctionnel pour répondre mais ne peut pas traiter la requête pour le moment, parce qu’il est en surcharge, limité en débit, au maximum de sessions, ou en maintenance. C’est le signal sur lequel un SBC souhaite le plus agir, car un 503 provenant d’un trunk est presque toujours une raison valable de basculer vers un autre. Première vérification : confirmez que votre comportement d’avancement de route bascule bien sur un 503, et recherchez un en-tête Retry-After.
504 Dépassement de délai du serveur
504 Dépassement de délai du serveur est le cousin « système chaîné » du 408 Request Timeout. La différence réside dans le minuteur qui a expiré. Un 408 signifie que votre propre minuteur de transaction a expiré en attendant une réponse. Un 504 signifie que le serveur qui vous a répondu attendait lui-même un serveur plus en amont qui n’a jamais répondu à temps. Un 504 vous indique donc que le répondeur est opérationnel et communique, mais que quelque chose dont il dépend ne l’est pas. Première vérification : le serveur retournant le 504 est joignable, donc le défaut se situe au-delà ; poursuivez la dépendance sur laquelle il a expiré plutôt que le pair qui a signalé le 504.
505 Version non prise en charge
505 Version non prise en charge signifie que la version SIP dans la ligne de requête n’est pas prise en charge. En pratique, c’est une pièce de musée, car SIP/2.0 est la seule version déployée depuis deux décennies. Si vous en voyez un, suspectez une ligne de requête mal formée ou un outil de test envoyant des données erronées, pas une véritable négociation de version.
513 Message trop volumineux
513 Message trop volumineux signifie que la requête a dépassé la taille que le serveur accepte sur le transport actuel. Ce code apparaît dans le monde réel plus souvent que sa rareté ne le suggère, presque toujours sur UDP, lorsqu’un INVITE dépasse la limite du datagramme en raison d’un corps SDP volumineux, d’un ensemble d’en-têtes étendu ou d’un en-tête Identity conséquent transportant un PASSporT STIR/SHAKEN. La solution est rarement de réduire le message ; il s’agit de basculer ce pair vers TCP ou TLS, où les messages volumineux ne sont pas contraints de la même manière. Première vérification : ce pair est-il sur UDP avec de gros INVITE ? Changez le transport.
580 Échec de précondition
580 Échec de précondition provient de la RFC 3312 et signifie que les préconditions SDP de l’offre n’ont pas pu être satisfaites, typiquement une réservation de ressource de qualité de service que le réseau n’a pas pu garantir avant d’établir l’appel. Ce code est rare, et vous ne le rencontrerez que dans des interconnexions qui conditionnent l’établissement d’appel à la réservation de ressources. Première vérification : vérifiez si les préconditions sont réellement requises sur ce segment, car de nombreux déploiements les négocient alors qu’ils n’en ont pas besoin.
503, Retry-After et contrôle de surcharge
Le 503 mérite un traitement à part car c’est le seul code 5xx doté d’un comportement de traitement intégré. C’est la façon standard pour un serveur de dire « je suis fonctionnel, mais je suis plein ou en maintenance, donc revenez plus tard ou allez voir ailleurs ». Traiter chaque 503 comme un échec définitif fait perdre tout l’intérêt du code.
L’élément clé est l’en-tête Retry-After, défini dans la RFC 3261 section 20.33. Lorsqu’un serveur inclut Retry-After, il indique à l’appelant combien de secondes attendre avant de réessayer ce serveur spécifique. Un SBC bien conçu respecte ce délai en dépriorisant temporairement cette route pendant l’intervalle indiqué, au lieu de solliciter un serveur qui a explicitement demandé un répit. Ignorer Retry-After et réessayer immédiatement tend à pousser un serveur déjà chargé encore plus au-delà de ses limites.
Au-delà du Retry-After par message, SIP définit un moyen standardisé pour qu’un serveur surchargé demande à l’amont de réduire le trafic avant de devoir commencer à tout rejeter. La RFC 5390 établit les exigences pour le contrôle de surcharge SIP, et la RFC 7339 définit le mécanisme : des paramètres de contrôle de surcharge transportés dans l’en-tête Via qui permettent à un élément en aval d’indiquer à son voisin en amont de délester un pourcentage du trafic. Lorsque les deux côtés l’implémentent, la congestion est gérée de manière fluide et les tempêtes de 503 ne se déclenchent jamais. Beaucoup de pairs ne l’implémentent pas, cependant, et émettent simplement des 503 une fois leur limite atteinte, c’est pourquoi la réaction de votre SBC à un 503 simple reste importante.
Les enseignements pratiques sont simples. Un 503 provenant d’un primaire fonctionnel devrait basculer proprement vers une route de secours. Une vague soudaine de 503 est un signal de capacité ou de panne au niveau du trunk, pas un défaut par appel, et devrait être interprétée comme « cet opérateur est en difficulté » plutôt que « cet appel était défectueux ».
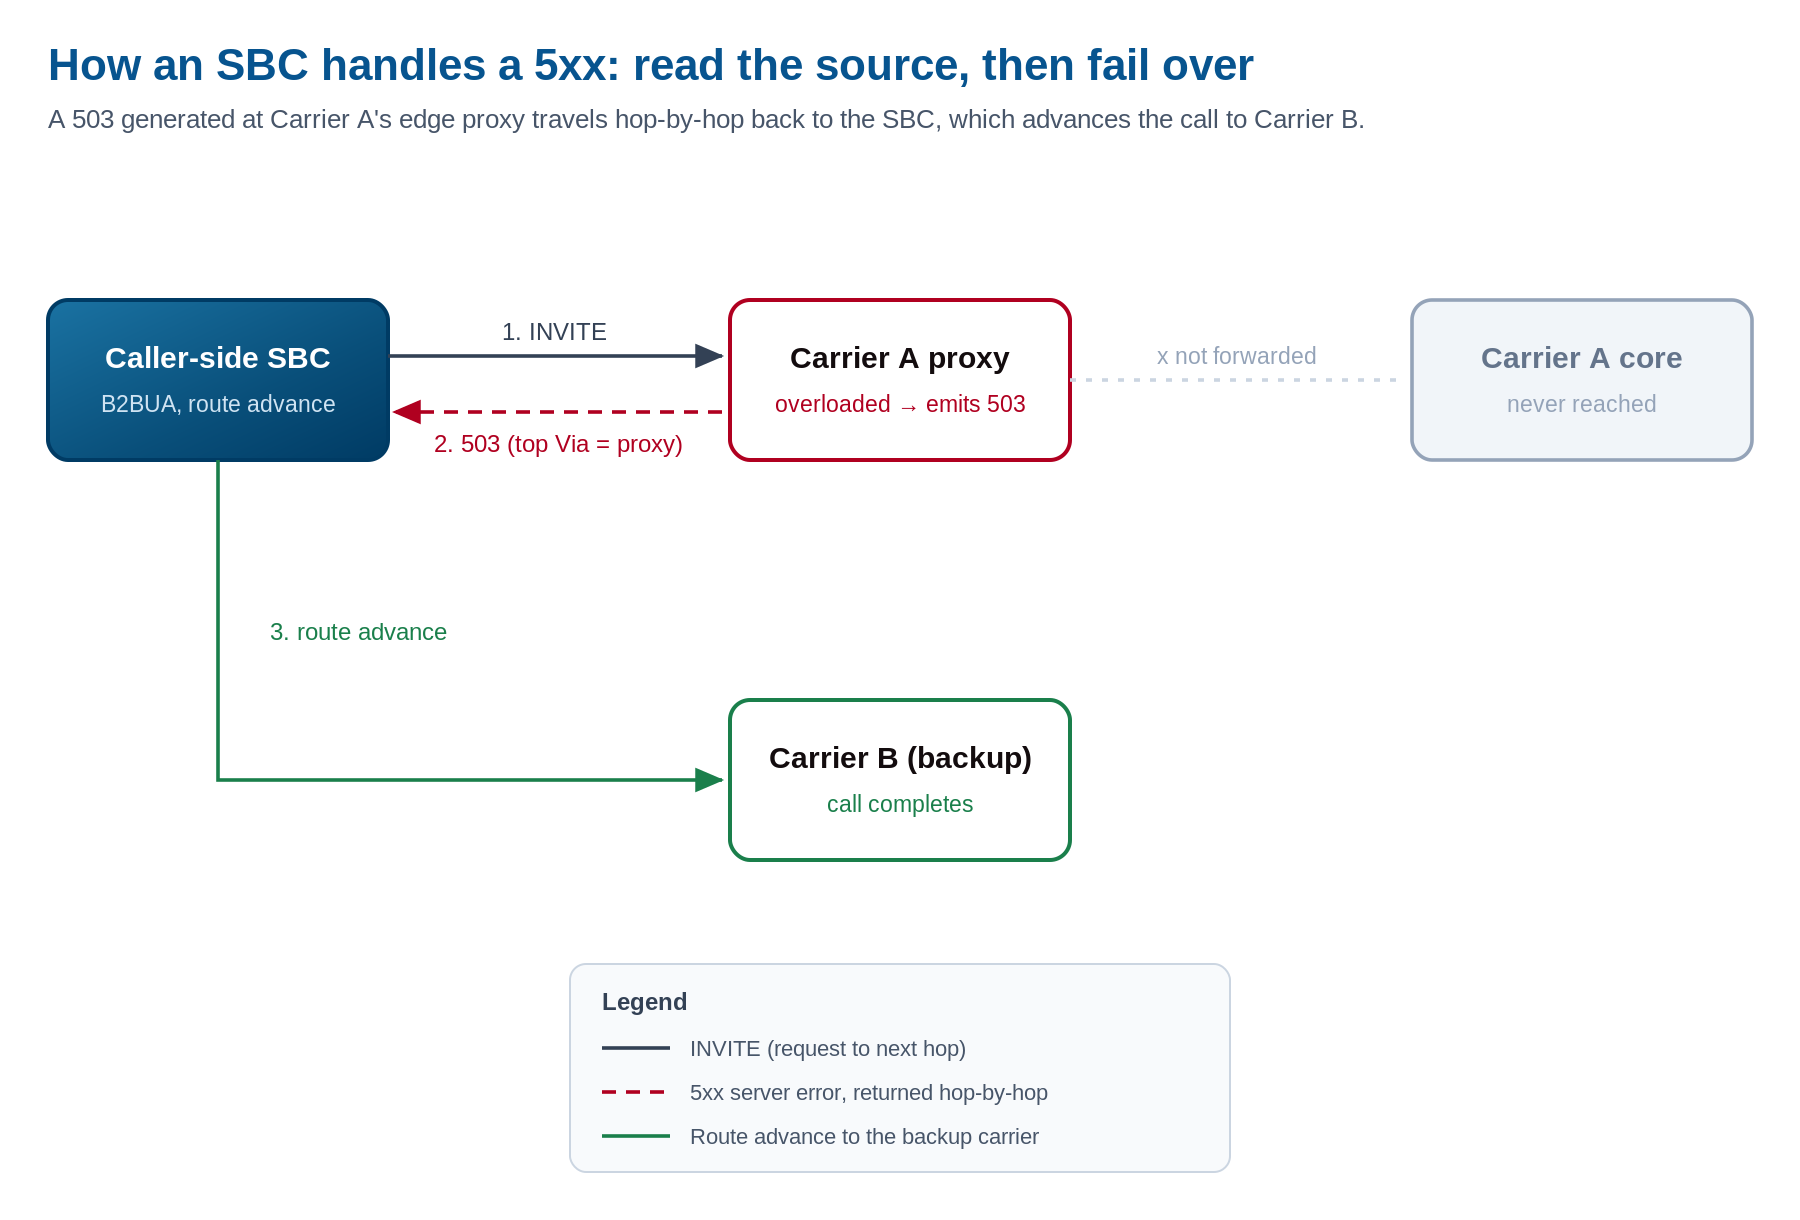
Un 503 est généré au proxy de bordure de l’opérateur A et remonte saut par saut jusqu’au SBC, non pas depuis le cœur de réseau de l’opérateur situé derrière. Le SBC lit le Via le plus haut pour identifier quel élément a échoué, puis avance l’appel vers un opérateur de secours. Cliquez pour agrandir.
À quoi ressemble un 5xx dans une capture de paquets
Lire un 5xx dans une trace revient principalement à répondre à une question : quel élément l’a envoyé ? La pile d’en-têtes Via est l’endroit où vous le découvrez. L’entrée Via la plus haute associée au traitement de la réponse identifie le saut qui l’a générée, de sorte qu’un 503 dont le Via le plus haut est le proxy de bordure de l’opérateur a été émis à cet endroit, pas par le commutateur de destination situé derrière. Cela vous indique immédiatement jusqu’où l’appel est réellement parvenu.
La nature saut par saut de la plupart des codes 5xx est en soi un indice. Puisqu’un intermédiaire a généré la réponse, elle ne portera pas le contexte de bout en bout que vous verriez de la part du terminal appelé, ce qui confirme que l’appel n’a jamais atteint l’extrémité distante. Recherchez également un en-tête Warning, défini dans la RFC 3261, qui contient souvent une courte explication lisible, et un en-tête Reason de la RFC 3326, qui peut transporter une valeur de cause Q.850 lorsque l’échec est relayé depuis un réseau TDM. Ces deux en-têtes sont l’endroit où le « pourquoi » se cache habituellement.
Un autre comportement utile à connaître pour la lecture de traces : l’ACK pour les réponses finales non-2xx est généré au sein de la transaction INVITE et suit le chemin de signalisation existant, contrairement à l’ACK de bout en bout qu’un 200 OK requiert. Si vous voyez un 5xx sans ACK correspondant, la transaction ne s’est pas terminée correctement, et c’est un problème à part entière à investiguer. Pour la méthode générale de lecture de toute trace SIP, un guide dédié à la lecture de traces couvre les points de capture et les outils, et l’article sur le flux d’appel SIP montre où ces codes apparaissent dans un appel complet ; cette section ne couvre que la partie spécifique aux 5xx.
Comment un SBC traite les codes 5xx
La raison pour laquelle un SBC se positionne en bordure d’un réseau multi-opérateurs est précisément pour qu’une erreur serveur ponctuelle ne devienne pas un appel perdu pour votre client. Un SBC B2BUA termine le segment entrant et initie un segment sortant indépendant, ce qui signifie qu’il voit le 5xx d’un côté et décide, selon ses propres règles, ce que l’autre côté doit entendre. Le même contrôle qui permet la manipulation d’en-têtes SIP et la signalisation SIP sur chaque segment lui permet de réécrire un code de réponse ou de modifier la décision de routage qu’il déclenche.
Le comportement fondamental est l’avancement de route. Le SBC traduit un 5xx en « avancer vers la route suivante » de sorte qu’une erreur serveur chez un opérateur bascule l’appel vers un chemin de secours, tandis qu’un 4xx est généralement laissé tel quel pour arrêter l’appel, car réessayer une requête rejetée ailleurs aide rarement. Le respect du Retry-After constitue la couche suivante : lorsqu’un 503 l’inclut, le SBC marque cette route comme indisponible pendant l’intervalle indiqué plutôt que de réessayer contre un mur. Des 503 répétés provenant du même pair peuvent l’exclure entièrement de la rotation jusqu’à ce que des keepalives OPTIONS montrent qu’il a récupéré, de sorte qu’un opérateur dégradé cesse automatiquement d’attirer du trafic.
Les réseaux réels sont suffisamment complexes pour que ces décisions doivent être configurées par groupe de trunks plutôt que globalement, car le 503 d’un opérateur peut signifier une congestion réelle tandis que celui d’un autre signale une panne à escalader immédiatement. ProSBC gère cela avec un contrôle par segment sur jusqu’à 1 024 Network Access Points (groupes de trunks), de sorte que le comportement d’avancement de route et de code de cause pour chaque pair peut correspondre à ce que ce pair fait réellement. Fort de plus de vingt ans de déploiement SIP opérateur et d’une capacité allant jusqu’à 60 000 sessions par serveur, ce contrôle par pair est ce qui maintient un traitement 5xx cohérent lorsque des dizaines d’opérateurs se comportent différemment à grande échelle.
Le dernier élément est la visibilité. Un taux de 5xx en hausse sur un trunk est le premier signe lisible par machine d’une panne côté opérateur, généralement visible dans votre supervision avant qu’un seul client ne s’en aperçoive. Afficher les compteurs de 5xx par route sur un tableau de bord, avec des seuils d’alerte, transforme les mêmes codes qui pilotent le basculement automatique en un système d’alerte précoce pour les équipes d’astreinte.
Questions fréquemment posées
Un 503 est-il un échec d’appel ?
Pas vraiment. Un 503 est un signal « réessayez ailleurs », et si votre SBC bascule correctement, l’appel aboutit malgré tout. Filtrez les événements 503-puis-basculement de vos métriques d’échec brutes et comptabilisez-les comme des basculements réussis ; sinon, vos tableaux de bord surévalueront le nombre d’appels réellement échoués.
Devrait-on réessayer un 5xx auprès du même serveur ?
Uniquement après l’intervalle indiqué dans un en-tête Retry-After, ou avec un délai progressif raisonnable. Un réessai immédiat auprès du même serveur produit généralement le même 5xx, et durant une surcharge, il aggrave la surcharge.
Quelle est la différence entre 408 et 504 ?
Quel minuteur a expiré. Un 408 Request Timeout signifie que votre propre transaction a expiré en attendant une réponse. Un 504 Dépassement de délai du serveur signifie que le serveur vous a répondu mais qu’il attendait un serveur plus en amont qui n’a jamais répondu. Avec un 504, le pair avec lequel vous communiquez est opérationnel ; la dépendance derrière lui ne l’est pas.
Pourquoi est-ce que je reçois un 503 d’un opérateur qui est manifestement opérationnel ?
Presque toujours une question de capacité, pas de santé. Les plafonds de sessions, la limitation de débit et le contrôle de surcharge se manifestent tous sous forme de 503 provenant d’un commutateur parfaitement fonctionnel. Cela signifie « plein », pas « en panne ».
Pourquoi les gros INVITE reviennent-ils avec un 513 ?
Le message a dépassé la limite de taille du transport, qui est dans la grande majorité des cas une contrainte de datagramme UDP. Basculez ce pair vers TCP ou TLS et l’INVITE surdimensionné, souvent gonflé par un SDP volumineux ou un en-tête Identity STIR/SHAKEN, passera sans problème.
Conclusion
La classe 5xx est petite mais à forte valeur ajoutée : des erreurs côté serveur qui sont généralement ré-acheminables vers un autre chemin, et le moteur de la quasi-totalité des basculements propres dans un réseau vocal. Savoir quel élément a émis le code, si un Retry-After est joint, et si la cause est un problème de santé ou de capacité, c’est ce qui transforme une erreur serveur en appel rerouté plutôt qu’en appel mort. Gardez le guide complet des codes de réponse à portée de main pour les cinq autres classes, et considérez les codes 5xx comme votre boîte à outils d’avancement de route.
Transformez chaque erreur serveur en basculement propre avec ProSBC
En tant que B2BUA complet, ProSBC termine et ré-initie chaque segment d’appel, lui permettant de transformer tout 5xx d’un pair en la décision de routage dont votre réseau a réellement besoin : avancer vers un opérateur de secours, respecter un intervalle Retry-After, maintenir un pair surchargé hors rotation jusqu’à sa récupération, et alimenter le taux de 5xx directement dans la supervision.
Son moteur de routage piloté par règles et API prend en charge le basculement multi-route par priorité, et le contrôle par NAP sur jusqu’à 1 024 groupes de trunks signifie que l’utilisation idiosyncrasique du 503, du 500 et des autres codes par chaque opérateur peut être traitée selon ses propres conditions plutôt qu’avec une règle globale unique.
Vous préférez évaluer par vous-même d’abord ? Commencez votre essai gratuit de 30 jours.