Guide de dépannage VoIP : problèmes courants, diagnostics de première passe et prochaines étapes
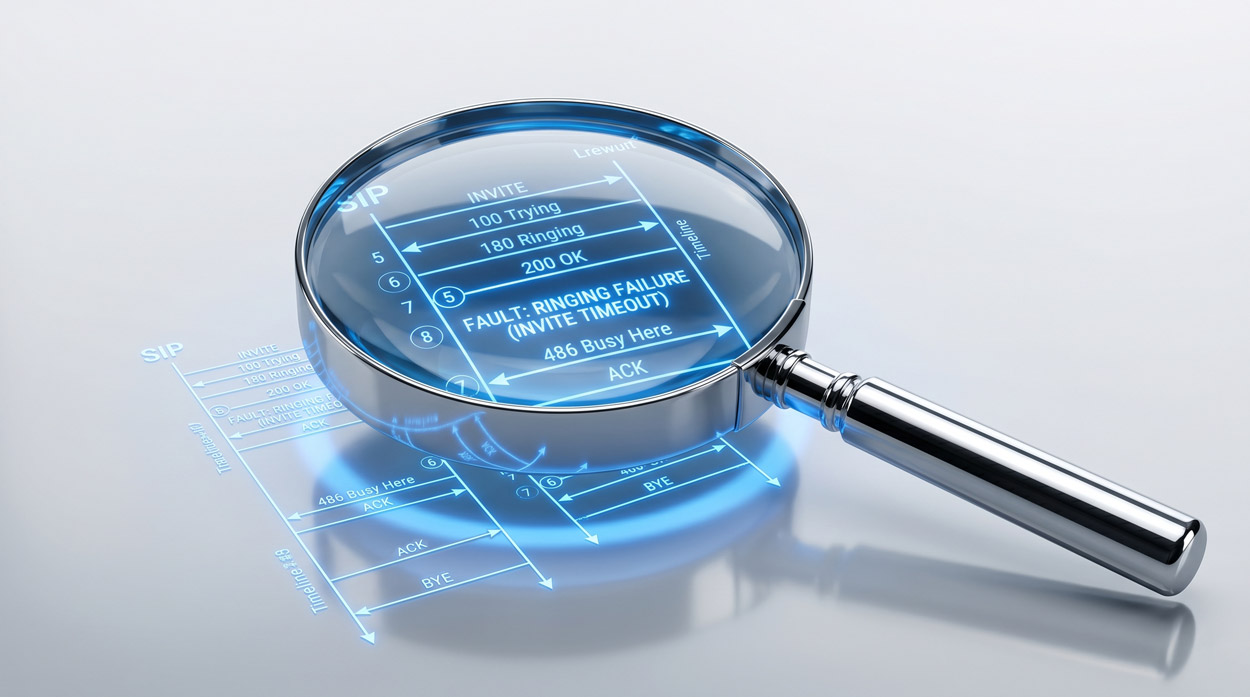
Lorsqu’un client signale que sa VoIP « ne fonctionne plus », les dix premières minutes donnent le ton pour le reste du ticket. La bonne réaction est rarement de modifier des paramètres. C’est de capturer suffisamment de preuves pour isoler l’emplacement de la panne, puis d’appliquer la correction la plus ciblée possible. Ce guide est la vue d’ensemble du dépannage VoIP : les symptômes les plus fréquents observés par les opérateurs, l’étape de diagnostic qui isole chacun d’eux rapidement, et les guides compagnons à consulter lorsqu’un symptôme nécessite une analyse approfondie.
La structure est délibérément orientée par les symptômes. L’article associe chaque symptôme à ses causes les plus probables, à la preuve unique qui les confirme ou les élimine, et aux pistes de résolution qui rétablissent l’appel.

Les 5 minutes de première passe
Avant de modifier le moindre paramètre, capturez les preuves. Reconfigurer avant de comprendre la cause racine en profondeur peut entraîner davantage de temps d’arrêt.
Les cinq informations à recueillir en premier sont : l’horodatage de l’appel (à la seconde près), la direction (entrant ou sortant du point de vue de l’opérateur), les numéros d’origine et de destination, si le transcodage était requis, et l’erreur exacte que l’utilisateur a vue ou entendue. Si l’utilisateur « n’a rien entendu du tout », c’est un problème différent de « j’ai eu une tonalité d’occupation rapide », qui est encore différent de « l’appel s’est connecté puis a coupé après vingt secondes ».
L’étape suivante consiste à isoler la panne selon quatre axes. S’agit-il d’une panne de signalisation (l’appel ne s’est jamais connecté) ou d’une panne média (l’appel s’est connecté mais l’audio a échoué) ? La panne s’est-elle produite du côté origine du SBC ou du côté terminaison ? S’agit-il d’un appel on-net (entre deux points terminaux contrôlés par l’opérateur) ou off-net (vers une destination externe) ? Et s’agit-il d’un incident isolé, d’un schéma intermittent ou d’une panne systématique affectant tous les appels ?
La question la plus diagnostique à ce stade est presque toujours : est-ce que cela fonctionnait avant ? Si oui, la question suivante est : qu’est-ce qui a changé ? Une rotation de certificat, une mise à jour de règle de routage, un changement d’opérateur en amont, une modification de politique de pare-feu ou une mise à jour logicielle est la cause d’une part disproportionnée des incidents VoIP. Le journal des changements trouve généralement le problème plus rapidement que la trace.
Symptôme 1 : les appels ne se connectent pas
L’appel échoue avant même que l’audio ait une chance de s’établir. Pas de sonnerie, pas de réponse, pas de média.
Les causes les plus probables sont une panne de signalisation SIP (l’INVITE ne reçoit jamais de 200 OK), une inscription qui n’a pas eu lieu ou a expiré (le point terminal est injoignable car il n’est pas inscrit), une ACL ou une règle anti-fraude bloquant l’adresse IP source ou le numéro appelé, une règle de routage qui ne correspond pas au schéma composé, ou un échec de handshake TLS sur un trunk chiffré.
La première étape de diagnostic consiste à lire le code de réponse SIP sur l’INVITE en échec. Une réponse 4xx signifie que la requête avait un problème côté client (authentification, permission, format, codec). Une réponse 5xx signifie que le serveur n’a pas pu traiter la requête même si elle était valide (timeout, erreur interne, manque de ressources). Une réponse 6xx est un refus global qui doit être traité comme définitif. Pour le catalogue complet, consultez la référence compagnon sur les fondamentaux de la signalisation SIP ; les schémas les plus récurrents en exploitation sont ci-dessous.
Un 403 Forbidden signifie presque toujours un contrôle d’accès. Soit les identifiants ont échoué à l’authentification, soit une règle anti-fraude a mis la destination en liste de blocage. Un 404 Not Found signifie généralement que le numéro composé ne correspondait à aucune règle de routage. Un 408 Request Timeout signifie que le saut suivant n’a pas répondu, souvent parce que le pair est injoignable sur le réseau ou a cessé d’envoyer des OPTIONS. Un 488 Not Acceptable Here pointe typiquement vers une incompatibilité de codec, le SDP entrant n’offrant aucun codec accepté par le côté terminaison. Un 503 Service Unavailable signifie, spécifiquement, que le saut suivant n’accepte pas d’appels à ce moment. Cela signifie souvent que le saut suivant est surchargé, bien que ce ne soit pas nécessairement le cas et que cela puisse être une hypothèse dangereuse lors de l’investigation.
Symptôme 2 : problèmes de connexion audio, absence d’audio et audio unidirectionnel
L’appel a été signalé avec succès (200 OK retourné, ACK envoyé), mais l’audio est absent dans une ou les deux directions. Les utilisateurs décrivent typiquement : « je les entends mais ils ne m’entendent pas » ou « l’appel se connecte mais c’est le silence complet ».
Les quatre causes racines probables sont un pare-feu bloquant le chemin RTP, un SDP annonçant la mauvaise adresse IP ou plage de ports, un problème de routage asymétrique où le RTP passe dans un sens par un chemin et dans l’autre par un chemin différent, ou une incompatibilité de clé SRTP où un côté ne peut pas déchiffrer le média de l’autre.
La première étape de diagnostic consiste à capturer la signalisation et le média sur l’interface du SBC. Si les paquets RTP circulent dans une seule direction, le problème est un blocage par le pare-feu du côté où le flux est absent. Si le RTP ne circule pas du tout, le problème se situe dans le SDP, généralement une adresse IP privée annoncée là où une adresse publique était attendue, ou un port média en dehors de la plage autorisée par le pare-feu. Si le RTP circule dans les deux directions mais que l’audio est silencieux ou déformé, le problème est le chiffrement ou la négociation de codec.
Symptôme 3 : problèmes de qualité audio
L’appel se connecte, les deux côtés entendent l’audio, mais l’audio est mauvais. Haché, robotique, coupures, écho, ou simplement en dessous du niveau de qualité vocale promis par le SLA de l’opérateur.
Les causes probables sont la perte de paquets (typiquement, au-delà de 1 %, elle devient audible), la gigue dépassant la capacité du tampon de réception, la latence de bout en bout supérieure à 150 ms en aller simple, les artefacts de transcodage (notamment avec un codec à faible débit), ou l’écho provenant d’un segment hybride quelque part dans le chemin.
La première étape de diagnostic consiste à vérifier l’outil de trace d’appel du SBC. Si le MOS est inférieur à 3,5, que le codec est G.711 et que l’appel comporte plus de quelques secondes d’audio, le réseau est le suspect, pas le SBC. La décomposition du MOS en ses composantes (gigue, perte de paquets, latence) pointe vers la couche spécifique en défaut. Les seuils complets, la méthodologie de surveillance par trunk et l’architecture des métriques sont couverts dans l’article compagnon sur les bonnes pratiques de surveillance VoIP, qui devrait être la référence opérationnelle pour quiconque met en place une pratique de surveillance de la qualité.
En exploitation réelle, trois schémas produisent la plupart des plaintes de qualité. La congestion WAN sur une route d’opérateur spécifique, généralement visible par des pics de perte de paquets sur les appels acheminés via ce trunk tandis que les autres trunks restent propres. La QoS qui devait être appliquée mais ne l’est pas. Et les tampons de gigue dimensionnés pour un profil réseau différent de celui en usage, soit trop petits (la gigue se transforme en coupures audibles), soit trop grands (la latence devient audible).
Symptôme 4 : les appels coupent en cours de conversation
L’appel était connecté, l’audio circulait, puis l’appel s’est terminé sans qu’aucune des parties ne raccroche. La description de l’utilisateur est généralement « on a été coupés ».
Les causes probables sont l’expiration du minuteur de session sans rafraîchissement, un échec de keepalive RTP provoquant l’expiration du média côté récepteur, un binding NAT ayant expiré et coupé le chemin, un BYE initié par le pair déclenché par la détection de silence (certains PBX coupent les appels qu’ils estiment terminés), ou une coupure réseau sur un trunk chiffré TLS ayant rompu le canal sécurisé.
La question la plus diagnostique est le moment exact de la coupure. Si les appels coupent systématiquement à une durée presque identique, la cause est un minuteur quelque part dans le chemin. Trente-deux secondes pointent généralement vers un Session Refresh non honoré. Si le moment de coupure est aléatoire, la cause est réseau : un lien instable, un rechargement transitoire de pare-feu ou un événement de convergence BGP en amont.
Les problèmes de minuteur de session sont le sous-ensemble le plus fréquent de coupures en cours d’appel et les plus faciles à corriger depuis le SBC. La règle de normalisation consiste à insérer un en-tête Session-Expires avec une valeur que la destination acceptera, ou à supprimer entièrement le minuteur sur les segments qui le gèrent mal.
Symptôme 5 : boucles d’inscription ou points terminaux hors ligne
Le point terminal apparaît hors ligne dans le tableau de bord de gestion.
Les causes probables sont une ACL bloquant le trafic REGISTER (souvent parce qu’une règle anti-fraude a confondu une réinscription légitime avec une attaque par balayage), une incompatibilité d’identifiants après une rotation de mot de passe, un intervalle de keepalive NAT plus long que le délai d’expiration du binding, du trafic de scan ou d’attaque perturbant la logique de détection, ou un certificat TLS expiré d’un côté ou de l’autre.
La première étape de diagnostic consiste à extraire les journaux du SBC pour le point terminal concerné. Le journal montrera les tentatives d’inscription et la réponse du SBC. Un challenge 401 suivi d’un 200 OK réussi est le schéma normal. Un 401 suivi d’un autre 401 indique que le SBC a rejeté l’inscription catégoriquement. L’identification de la cause racine doit se faire au niveau du registrar. Si le SBC est le registrar, ces journaux seront informatifs. Si le SBC n’est pas le registrar, les journaux du SBC ne vous diront qu’une partie de l’histoire.
Le guide compagnon sur la prévention des attaques DoS SIP couvre la frontière entre les schémas d’inscription légitimes et les attaques par balayage en profondeur, et constitue la référence pour ajuster les seuils.
Symptôme 6 : échecs DTMF
L’appel se connecte avec un bon audio, mais le SVI (serveur vocal interactif) ne peut pas lire les chiffres que l’appelant compose.
Les causes probables sont une incompatibilité de mode DTMF (un côté envoie des tonalités audio intrabande, l’autre attend des telephone-events RFC 2833 ou des messages SIP INFO), un transcodage supprimant le DTMF en transit, ou une incompatibilité de type de payload sur le payload RTP telephone-event (un côté utilisant le type 101, l’autre attendant le type 96).
La première étape de diagnostic consiste à capturer le média et à vérifier que ce qui est envoyé correspond à ce qui devrait l’être. Si l’utilisateur appuie sur un chiffre et que la trace montre un paquet telephone-event RFC 2833 avec le bon numéro, le problème est en aval. Si la trace montre des tonalités audio intrabande alors que la destination a négocié RFC 2833, c’est l’incompatibilité. Un SBC B2BUA avec une unité de transcodage peut normaliser entre les modes DTMF par segment, ce qui est généralement la correction la plus rapide dans les environnements mixtes.
Un cas spécifique à signaler : les codecs à faible débit (tout codec avec compression agressive) peuvent supprimer entièrement le DTMF intrabande. Si le chemin inclut un transcodage et que la source envoie des tonalités intrabande, l’appel ne peut pas transporter le DTMF de manière fiable. La solution consiste à négocier des telephone-events RFC 2833 de bout en bout, ou à maintenir le chemin en G.711 si le DTMF doit rester intrabande.
Symptôme 7 : échecs de fax
Le fax est extrêmement sensible à la perte de paquets, à la gigue et au choix du codec. Les causes probables sont un transcodage agressif brisant le protocole T.30, une perte de paquets au-dessus du seuil de tolérance du fax (généralement autour de 0,5 %), l’absence de négociation T.38 alors que les deux côtés le prennent en charge, ou un tampon de gigue absorbant les tonalités de handshake V.21 au début de la session fax.
La première étape de diagnostic consiste à déterminer si le chemin utilise le relais T.38 ou le passthrough G.711. Le T.38 démodule le signal fax en un protocole numérique sur UDPTL, qui tolère bien la perte et la gigue. Le passthrough G.711 transporte les tonalités analogiques du fax à l’intérieur du codec voix, ce qui est fragile en cas de perte. Si le chemin a tenté de négocier T.38 mais est retombé en G.711, la renégociation SDP montre généralement la raison. Le guide compagnon Fax sur IP et T.38 couvre le parcours de diagnostic complet, le profil de codec compatible fax et les paramètres SBC qui rendent le fax fiable.
Symptôme 8 : les appels n’atteignent pas la destination spécifiée
La plupart des appels réussissent, mais un numéro, un préfixe ou un opérateur spécifique rejette systématiquement les appels.
Les causes probables sont un rejet côté opérateur (identifiant de l’appelant non inscrit en liste blanche, niveau d’attestation trop bas, blocage géographique), une incompatibilité de format de numéro (E.164 par rapport à national par rapport à local, ou chiffres supplémentaires dans l’en-tête From), une règle de mapping par NAP manquante pour la nouvelle destination, ou un problème d’attestation STIR/SHAKEN où les appels signés en dessous du niveau A sont bloqués par l’opérateur de terminaison.
Le diagnostic le plus utile consiste à identifier le trunk SIP ou le NAP par lequel l’appel en échec est passé, puis à le réacheminer via une alternative. Si l’appel réussit sur le trunk alternatif, la normalisation, l’attestation ou la logique de routage du trunk d’origine est en cause. S’il échoue également sur l’alternative, c’est le côté destination qui rejette en fonction d’un élément de l’appel (identifiant de l’appelant, attestation, liste de blocage).
Si les échecs se concentrent autour de changements réglementaires récents, examinez l’attestation. Plusieurs grands opérateurs américains rétrogradent ou bloquent les appels signés en dessous du niveau A, et les fournisseurs qui comptaient sur un partenaire de gros en amont pour la signature ont vu leur attestation effective baisser. Le guide d’attestation STIR/SHAKEN niveau A couvre le parcours opérationnel du niveau C au niveau A et les exigences de la FCC pour chacun.
Symptôme 9 : problèmes spécifiques au routage direct Teams (Direct Routing)
Le routage direct Microsoft Teams (Direct Routing) possède son propre ensemble de schémas de panne, car les exigences SBC de Microsoft sont strictes et non négociables. Les échecs de heartbeat SIP OPTIONS, les erreurs de handshake TLS, les incompatibilités FQDN entre le certificat du SBC et ce qui est enregistré dans le Centre d’administration Teams, et les problèmes de négociation SRTP sont les plus fréquents.
Une vérification de première passe consiste à examiner le statut du SBC dans le Centre d’administration Teams. S’il apparaît hors ligne, le heartbeat OPTIONS échoue. La cause est généralement un problème de handshake TLS (certificat expiré, certificat intermédiaire manquant, ou le prochain changement de liste de confiance des autorités de certification racines de Microsoft), ou un chemin réseau interrompu entre le SBC et Microsoft. La mise à jour du certificat d’autorité racine Microsoft 2026 est le scénario de panne à court terme le plus important à vérifier. Pour les exigences complètes du routage direct et les critères de sélection de SBC, consultez la page d’apprentissage sur le routage direct Teams.
La boîte à outils de diagnostic
Quatre outils couvrent la grande majorité du travail de dépannage VoIP, et un opérateur qui les a tous prêts avant l’arrivée du premier ticket résout les problèmes plusieurs fois plus vite que celui qui doit les assembler sous pression.
La trace d’appel du SBC est le premier arrêt pour toute question de signalisation, produisant un diagramme en échelle SIP par appel montrant chaque message échangé sur les deux segments. La sortie CDR du SBC donne le résumé post-appel, incluant la durée, les codecs, le MOS et la cause de raccrochage. Les traps SNMP et un tableau de surveillance de base couvrent les schémas systématiques. Et une capture PCAP sur l’interface du SBC, ouverte dans Wireshark, donne la vérité brute lorsque les traces et les CDR ne s’accordent pas sur ce qui s’est passé.
Quand escalader vers votre opérateur
Trois signaux suggèrent fortement que le problème se situe en amont plutôt que dans l’infrastructure propre de l’opérateur. Plusieurs trunks d’origine constatent la même panne vers la même plage de destinations. Plusieurs destinations sur un seul trunk échouent toutes en même temps. La trace SIP du SBC montre la réponse d’erreur provenant du côté opérateur (5xx, 6xx, ou un long délai suivi d’un 408).
Le dossier à fournir à l’opérateur doit toujours inclure une trace SIP couvrant l’appel en échec depuis la perspective du SBC, un PCAP de l’interface du SBC pour la période concernée, et un petit ensemble d’exemples d’appels concrets (appelant, appelé, horodatage exact, durée, erreur). Les opérateurs avancent beaucoup plus vite lorsque la demande inclut les preuves spécifiques dont ils ont besoin pour retrouver l’appel dans leurs propres journaux. Les tickets vagues indiquant « les appels vers l’indicatif 305 échouent » sans horodatages ni exemples de numéros restent dans la file d’attente.
Comment ProSBC accélère la résolution des problèmes VoIP
ProSBC est conçu autour de la réalité opérationnelle selon laquelle les problèmes vocaux surviennent et doivent être diagnostiqués rapidement. Le scoring MOS par appel est calculé nativement au niveau du SBC, sans sonde externe requise. La sortie CDR de ProSBC inclut le chemin de signalisation, la cause de raccrochage, le codec sur chaque segment et les champs de qualité, aux formats texte et RADIUS. La capture de paquets compatible Wireshark en direct peut être activée par appel ou par NAP sans redémarrage. La trace d’appel SIP est accessible via l’interface de gestion web.
Le moteur de routage programmable Ruby est le point de levier pour les schémas de problèmes systématiques. Lorsqu’un opérateur spécifique envoie systématiquement des en-têtes malformés, des artefacts de transcodage ou des codes de réponse inhabituels, un script de routage peut normaliser le schéma au niveau du SBC plutôt que d’exiger que chaque PBX en aval le gère. Le même moteur prend en charge l’intégration en chaîne de filtres avec TransNexus ClearIP, Neustar, SecureLogix et YouMail pour les décisions de fraude, STIR/SHAKEN et scoring de réputation qui affectent l’aboutissement des appels.
Pour les opérateurs qui se retrouvent à gérer une pratique de dépannage plutôt qu’à gérer leur activité, le Managed Service TelcoBridges prend en charge le travail de diagnostic, les changements de configuration et la surveillance continue, tout en laissant une visibilité et un contrôle complets au client.
Résolvez les problèmes VoIP plus rapidement avec ProSBC
ProSBC est un contrôleur de session en bordure (SBC) logiciel de classe opérateur, conçu avec la surface de diagnostic dont les opérations réelles ont besoin. MOS par appel, capture de paquets en direct, sortie CDR complète, trace SIP via le web et normalisation programmable via le moteur de routage Ruby couvrent le flux de dépannage, du premier symptôme à la cause racine.
Pour les fournisseurs de services qui gèrent la surveillance comme une pratique, MaaS (Monitoring as a Service) est disponible en tant que produit autonome qui intègre les métriques dans un tableau de bord géré. Pour les opérateurs qui souhaitent se décharger entièrement du fardeau de diagnostic, le niveau Managed Service inclut ProSBC+ avec haute disponibilité 1+1, support niveau 3 24×7, changements de configuration continus et surveillance permanente.
ProSBC est disponible sur AWS, Microsoft Azure, VMware, KVM/Proxmox et bare metal. Un essai gratuit de 30 jours avec 500 sessions simultanées fournit un environnement de diagnostic complet pour l’évaluation, et la licence permanente ProSBC Lab à 3 sessions est disponible immédiatement pour les travaux de test et de validation.
Vous préférez évaluer par vous-même d’abord ? Commencez votre essai gratuit de 30 jours.